
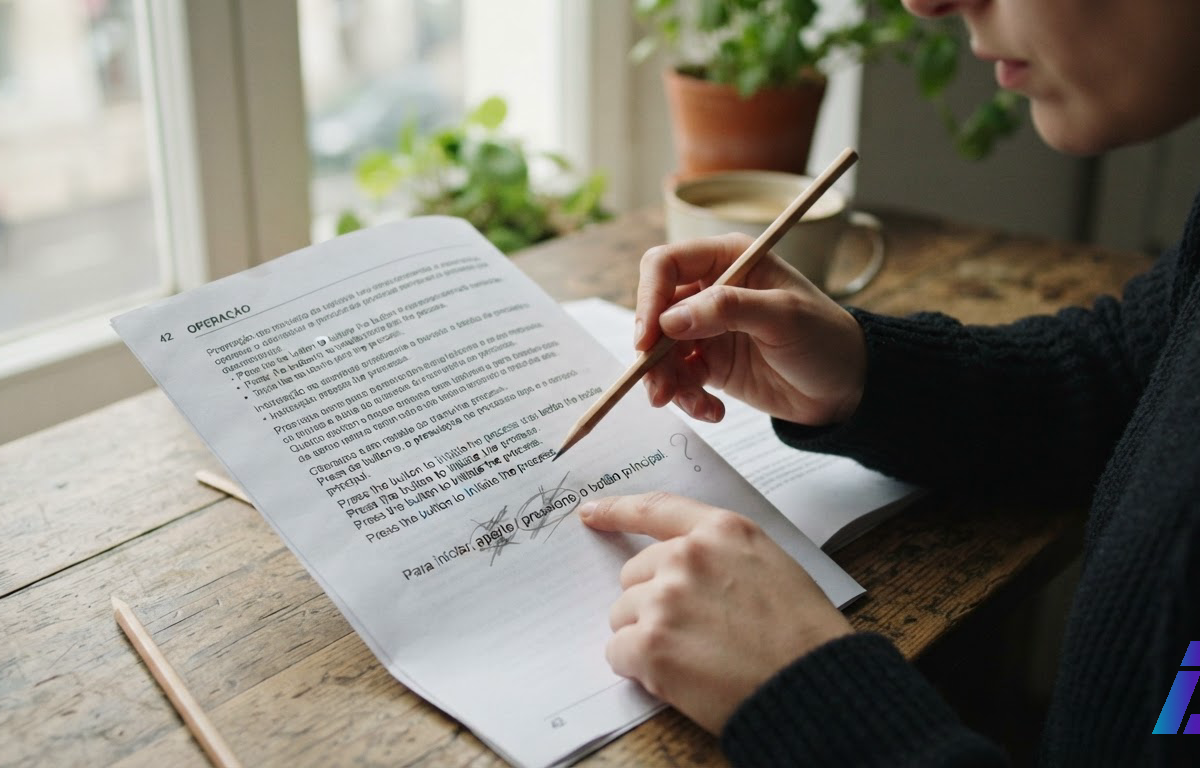
Em algum servidor, numa pasta com nome parecido com parallel_clean_v3, mora uma frase que alguém traduziu para o português num dia qualquer: "Pressione o botão até ouvir um clique." Não é Guimarães Rosa. Mas alguém leu o original e pensou se era "aperte" ou "pressione", se o clique se ouvia ou se escutava. Decidiu e foi almoçar. Essa pessoa não tem nome no arquivo. Tem, no máximo, um ID de segmento. Depois da deduplicação, nem isso.
Quem trabalha com tradução automática conhece esse tipo de arquivo como a gente conhece o arroz do supermercado: vem limpo e ensacado, sem a menor pista de quem plantou. É esse saco de arroz que Joss Moorkens e Monja Jannet abrem no capítulo Translation and data ethics (abre em nova aba). O texto foi publicado no arXiv em 20 de outubro e vai sair no livro Developing AI literacy for translation, pela Language Science Press. Foi pensado para um livro de letramento em IA voltado à tradução, mas quem deveria lê-lo com mais atenção são os desenvolvedores que montam os pipelines.
Minha tese é simples, e o capítulo me dá munição para ela. Dado de tradução talvez seja o dado mais autoral que existe, e nossos pipelines o tratam como o mais anônimo. A distância entre uma coisa e outra não é acidente técnico. É uma escolha de engenharia, e nenhuma regulação vai fazer essa escolha por nós. Então ela continua sendo nossa.
A frase tem dono duas vezes
Os autores partem de uma definição de Floridi e Taddeo: ética de dados é o subcampo que examina problemas morais ligados a dados, algoritmos e às práticas correspondentes. "Práticas" é a palavra que interessa aqui. Ninguém comete uma infração ética dentro de um tensor. Comete num script de ingestão.
A primeira prática que tropeça é a do direito autoral. A Convenção de Berna, lembram Moorkens e Jannet, protege traduções como obras derivadas "como obras originais, sem prejuízo dos direitos sobre a obra original". Na língua do dev: cada par de segmentos num corpus paralelo carrega duas camadas de direitos, a de quem escreveu e a de quem traduziu. O manual da máquina de lavar tem autor. A versão em português do manual também tem.
Existe ainda uma terceira camada, e é aqui que a coisa fica irônica. A Diretiva Europeia de Bases de Dados garante 15 anos de proteção a quem fez um investimento substancial na construção de um banco. A empresa que juntou as memórias de tradução tem, portanto, um direito bem desenhado sobre o conjunto, e a tradutora tem um direito sobre a frase. Na hora de treinar o modelo, adivinhe qual dos dois chega ao final com nome e sobrenome.
O capítulo retoma um trabalho de 2019 assinado por Moorkens e Lewis para dizer que rastrear a contribuição de um tradutor individual no treinamento de modelos neurais de tradução e de LLMs é "incrivelmente difícil ou praticamente impossível". Não discordo. Ninguém vai abrir os pesos e encontrar o "pressione" daquela moça.
"Impossível" depende de onde você olha
Só que o "praticamente impossível" vale para o fim da linha, para os pesos. No começo da linha, onde o dado entra, saber de onde veio cada lote é perfeitamente possível: basta um campo a mais no registro. A autoria não evapora no gradiente. Ela é apagada antes, numa etapa de limpeza que alguém escreveu, em que os metadados viram ruído e vão para o lixo junto com as tags HTML e as linhas duplicadas.
Isso muda o tipo de pergunta que o dev consegue responder. "Qual frase desse tradutor o modelo aprendeu?" não tem resposta. "Esse modelo foi treinado com material daquela agência? Sob qual licença? Conseguimos tirá-lo da próxima versão?" tem resposta, desde que alguém tenha guardado a informação. Na prática, o trabalho é pouco glamouroso:
- manter origem e licença por lote, e não só no "dataset final";
- não misturar no mesmo balde o que foi licenciado e o que foi raspado da web;
- conseguir excluir uma fonte inteira num retreinamento, sem precisar de arqueologia;
- documentar quais pares de idiomas vieram de quem.
Nada disso é pesquisa de ponta. É disciplina de engenharia de dados, a mesma que a gente aplica sem reclamar quando o assunto é dado pessoal e LGPD. A diferença é que, no caso do dado pessoal, existe multa. No caso do tradutor, existe só a consciência, e consciência raramente aparece no sprint planning. Por isso a coluna de origem é a primeira a cair quando o disco aperta ou o prazo encurta.
Quem tem dado manda
O viés aparece no capítulo ao lado de direito autoral e propriedade, como problema de qualquer tipo de dado. Na tradução, ele tem cara concreta. Um corpus é um sedimento de escolhas feitas por certas pessoas, para certos clientes, numa certa época. Quando a língua de origem não marca gênero e o português exige, o modelo escolhe, e escolhe pelo que viu mais vezes. Troque "gênero" por "variante", por "registro" ou por "qual comunidade tinha dinheiro para mandar traduzir" e o problema continua o mesmo.
Os autores separam esses problemas gerais dos que pesam sobre comunidades de línguas minorizadas e sobre quem está de cada lado da exclusão digital. Dado, escrevem, está implicado em desequilíbrios e dinâmicas de poder. O número que ancora o argumento vem de Eberhard e colegas: em 2025, 44% das línguas do mundo estavam ameaçadas.
Para um dev, a tentação é ler isso como chamado à caridade técnica. Língua com pouco dado? Raspa-se o que der, treina-se um modelo, todo mundo ganha. Às vezes ganha mesmo. Só que numa língua com poucos falantes e poucos textos, cada texto pesa muito mais, e quem coleta passa a controlar uma fatia desproporcional do registro escrito daquela comunidade. A pergunta deixa de ser "conseguimos treinar?" e vira "quem decide o que se faz com isso, e quem pode dizer não depois?". Se a resposta for "a empresa que hospeda o modelo", a gente reproduziu em Python uma dinâmica bem antiga.
O melhor argumento do outro lado
O contraponto merece ser levado a sério. Sem grandes corpora paralelos, coletados com alguma generosidade em relação a licenças, não existiria a tradução automática que usamos todo dia, nem a que começa a atender línguas pequenas. Exigir consentimento segmento por segmento mataria a pesquisa aberta e entregaria o campo a quem já tem dinheiro para licenciar tudo. E se a contribuição individual é impossível de rastrear, a remuneração individual também seria.
O argumento é bom, mas mira na versão maximalista da ética de dados, que ninguém sério propõe para amanhã. O que defendo aqui, e o que o capítulo ajuda a sustentar, é um piso: saber de onde veio cada lote, sob qual licença, com que tipo de anuência da comunidade, e conseguir desfazer. Isso não inviabiliza a pesquisa aberta. Ao contrário: um dataset aberto com procedência documentada é justamente o que permite a um pesquisador pequeno provar que fez as coisas direito. Quem se beneficia da opacidade é quem tem departamento jurídico para administrá-la.
Não espere a cavalaria
Uma das seções do capítulo faz a pergunta em voz alta: a regulação vai resolver esses problemas? Um dado trazido pelos próprios autores ajuda a responder. Pelo AI Act europeu, LLMs usados para tradução não são considerados, hoje, sistemas de alto risco. E é aos sistemas de alto risco que o regulamento reserva as exigências mais duras de governança dos dados de treinamento.
Aos olhos de Bruxelas, tradução é atividade de risco baixo. Para quem quer entender o cardápio de um restaurante em Lisboa, talvez seja. Para a tradutora cujo trabalho virou insumo, e para a comunidade cuja língua virou dataset, o risco é outro, e ele não está na lista.
Isso empurra a responsabilidade, tema com que Moorkens e Jannet fecham o texto, para perto do teclado. Os autores também registram que pesquisadores dos estudos de tradução vêm prestando cada vez mais atenção à ética de dados. É um bom sinal, mas vem do lado de quem traduz. Do lado de quem treina, a conversa costuma girar em torno de métrica de qualidade e custo de inferência.
Lá na pasta parallel_clean_v3, a frase do botão continua no mesmo lugar. Ninguém vai devolver o nome a ela, e o modelo já aprendeu o que tinha para aprender. Mas a próxima versão do corpus ainda não foi montada, e é nela que alguém vai decidir se a coluna de origem fica ou vai embora junto com as tags HTML. Esse alguém, quase sempre, é um desenvolvedor numa terça-feira à tarde, achando que está só limpando dados.