Quando duas pessoas colaboram na resolução de um problema difícil, elas precisam recorrer a um protocolo de compressão lento e com altas perdas chamado linguagem falada ou escrita. Cada indivíduo reduz uma rede complexa de estados mentais a uma sequência linear de palavras, transmite esses símbolos pelo ar ou por uma tela e espera que o interlocutor reconstrua, do outro lado, um estado mental equivalente. É compreensível que seres humanos funcionem assim, já que nossos cérebros são fisicamente isolados. O que beira o absurdo na engenharia de software atual é impor essa mesma restrição biológica a agentes de inteligência artificial que são, na maioria das vezes, instâncias de exatamente o mesmo modelo rodando nos mesmos chips de silício.
Em um artigo técnico submetido ao arXiv (abre em nova aba) em 3 de novembro de 2026, os pesquisadores Tianming Sha (Stony Brook University), Junnan Li (University of Wisconsin, em Madison) e Siqi Zhao (University of Minnesota) demonstraram o que acontece quando abolimos essa conversa intermediária. Com o framework experimental Octopus (abre em nova aba), um modelo compacto de 4 bilhões de parâmetros (Qwen3.5-4B (abre em nova aba)) operando apenas sobre um índice esparso BM25 alcançou 49,6% de acurácia no benchmark BrowseComp-Plus e 51,2% no OpenResearcher. Esse resultado supera sistemas de agentes baseados em recuperação densa (dense retrieval) até 250 vezes maiores, ao mesmo tempo em que multiplica a vazão (throughput) de treinamento por 3,3 e reduz o pico de consumo de memória KV em 2,8 vezes.
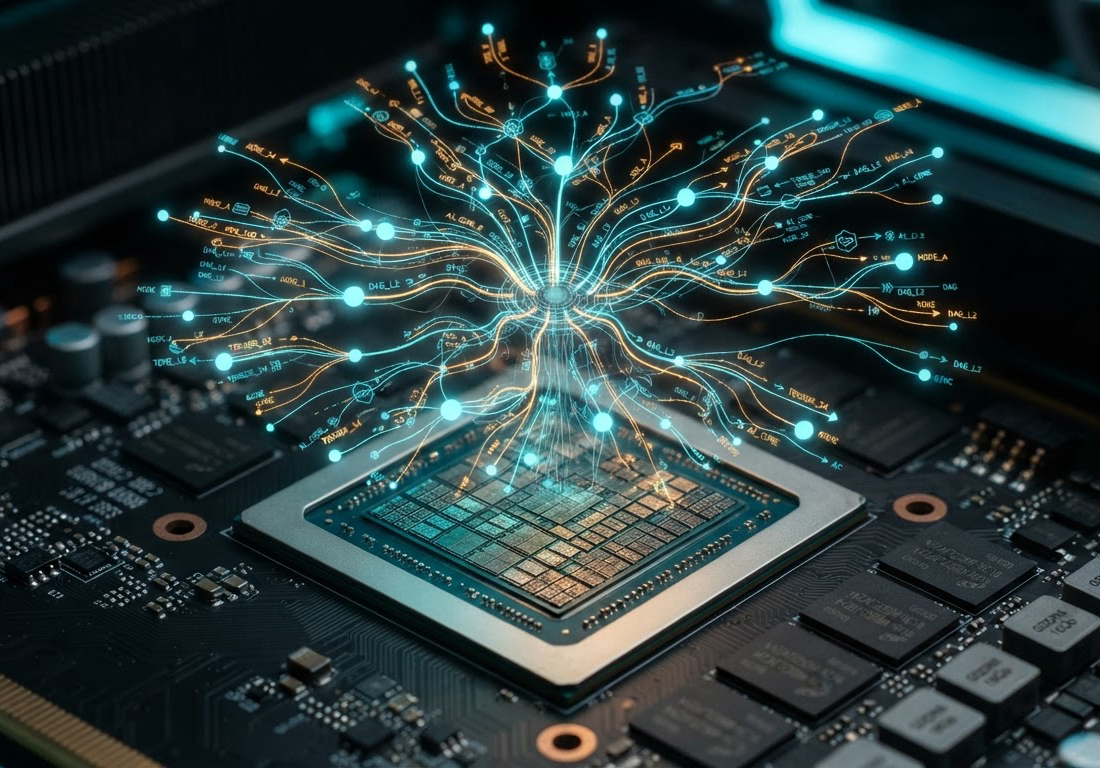
A premissa por trás desses números é uma mudança na representação física da memória durante a inferência e o aprendizado por reforço (RL). Em vez de instanciar múltiplos subagentes que duplicam prefixos de memória e trocam resumos em texto puro (o que exige reprocessar tokens que o modelo já leu), o Octopus trata todos os agentes como ramificações de um único cérebro. Eles coordenam suas buscas diretamente sobre um grafo acíclico dirigido (DAG) de estados de chave e valor (KV cache) residente na memória da GPU.
O trilema da janela plana e o custo cognitivo de não esquecer
A alternativa mais comum aos sistemas multiagentes conversacionais tem sido esticar a janela de contexto de um único agente. Na teoria, se um modelo suporta centenas de milhares de tokens, ele pode simplesmente anexar cada busca, leitura de documento e verificação em uma única fita contínua. Na prática, a pesquisa profunda não se comporta como uma linha reta, mas como uma árvore cheia de becos sem saída.
Quando um agente de contexto plano explora uma hipótese incorreta e lê um documento irrelevante de 8 mil tokens, esse desvio fracassado permanece gravado na memória de trabalho pelo resto do episódio. Os dados coletados pelos autores mostram que essa poluição dilui o mecanismo de atenção: um treinamento de RL com contexto plano de 143K tokens usando GRPO (Group Relative Policy Optimization) estagna em 32,1% de acurácia no BrowseComp-Plus, utilizando efetivamente apenas 28,5% da janela disponível. O agente para de explorar porque o ruído acumulado nas tentativas anteriores degrada a qualidade das decisões seguintes.
Tentar limpar essa fita editando o meio do contexto cria problemas mecânicos imediatos nos servidores de inferência modernos. Qualquer alteração intermediária invalida o cache de prefixo e, pior ainda, corrompe a matemática sequencial de modelos que utilizam camadas recorrentes lineares, como Gated DeltaNet ou Mamba-2. Por outro lado, quando os engenheiros recorrem aos wrappers de chat multiagentes tradicionais para isolar esses desvios em janelas separadas, o sistema cai no gargalo oposto: cada vez que um subagente devolve um resumo ou quando se tenta emendar o histórico bruto de uma thread irmã, a taxa de sequestro de tarefa (off-task hijacking) salta para a faixa de 55,2% a 57,9%. Mais da metade dos turnos subsequentes desvia do objetivo original por contaminação de contexto.
Anatomia de um pensamento ramificado na GPU
O Octopus resolve esse impasse virtualizando o raciocínio de longo horizonte. Em vez de uma fita linear ou de processos isolados que se comunicam via rede, um episódio de resolução de problemas é modelado como um grafo $G = (V, E_{\text{tree}}, E_{\text{mount}})$ endereçado por cursores diretamente na memória de vídeo. O modelo interage com essa estrutura por meio de cinco primitivas nativas: fork, read_thread, wait_threads, rewind e commit.
O primeiro pilar dessa arquitetura é o Zero-Copy Radix Forking, construído sobre o runtime de serving SGLang em conjunto com o framework de treinamento AReaL. Quando o agente decide investigar múltiplas hipóteses em paralelo via fork, ou quando descarta um caminho ruim via rewind, o sistema não copia blocos de memória nem reenvia o histórico pela rede. Os turnos concluídos persistem na GPU como cursores radix imutáveis; criar um novo ramo é uma operação de custo $\mathcal{O}(1)$ que apenas instancia uma nova visão de cursor sobre as mesmas páginas físicas de KV cache.
Para garantir que apenas as diferenças ($\mathcal{O}(|\Delta m|)$) trafeguem entre o controlador e a GPU, a equipe implementou um fatiador automático de templates de chat na inicialização, que registrou zero erros de tokenização em 18.344 testes distribuídos por sete famílias de modelos. Em testes reais executados ao longo de 447.993 lotes de prefill em GPUs H200, esse gerenciamento atingiu uma taxa de acerto (hit rate) de cache KV de 89,59%, cortando o tráfego de rede em 98,3% e reduzindo o tempo de montagem de um prompt de 128K tokens de 358,5 milissegundos para 1,44 milissegundo (uma aceleração de 249 vezes). Aqui no IA.com.br, acompanhamos de perto como gargalos de infraestrutura em sistemas de agentes têm migrado do poder bruto de cálculo dos pesos para a engenharia de movimentação de memória na GPU, e esses números deixam claro o tamanho do desperdício nos pipelines convencionais.
Graças a esse isolamento em árvore, o modelo treinado explora uma média de 329,2K tokens somando todas as ramificações de um episódio (usando janelas isoladas de 32K por ramo), mas mantém o prompt ativo que o modelo efetivamente processa a cada turno em enxutos 26,4K tokens.
Memória associativa versus memória de trabalho em modelos híbridos
Se ramificar é barato, o verdadeiro desafio técnico surge quando um ramo precisa ler o que outro descobriu. Como transferir o conhecimento latente da thread A para a thread B sem copiar texto e sem fazer a thread B assumir a personalidade ou o subobjetivo local da thread A?
A resposta encontrada pelos autores no mecanismo de Attention-Only KV Mounting é uma demonstração elegante de como a arquitetura interna dos LLMs modernos pode ser explorada a favor do sistema. O modelo base utilizado no estudo, o Qwen3.5-4B, possui uma estrutura híbrida composta por 24 camadas recorrentes Gated DeltaNet intercaladas com camadas de atenção completa (full-attention).
Em um modelo híbrido, esses dois tipos de camadas cumprem papéis cognitivos distintos:
- Camadas recorrentes lineares (Gated DeltaNet / Mamba-2): funcionam como uma memória de trabalho mutável ($h_B$), mantendo o estado operacional imediato de quem o agente é naquele instante e qual subtarefa está executando.
- Camadas de atenção completa: operam como um banco de dados associativo passivo, onde o modelo faz buscas por chave e valor sobre fatos já processados.
Quando a primitiva read_thread é acionada no Octopus, o gerenciador de memória realiza uma montagem seletiva por camada. Ele injeta os blocos terminais de KV da thread irmã exclusivamente nas camadas de atenção completa, aplicando deslocamentos (offsets) de posição monotônicos livres de rotação, definidos por $s(c'_B) = \max(p_B, e_A + 1)$. Enquanto isso, as 24 camadas recorrentes lineares simplesmente pulam os trechos montados, preservando intacto o seu estado oculto $h_B$.
O efeito prático dessa separação cirúrgica aparece com clareza nos dados de ablação do estudo:
| Métrica de Desempenho e Sistema | Baseline (Agente Único / Chat Multiagente) | Framework Octopus (Qwen3.5-4B) | Impacto Direto |
|---|---|---|---|
| Acurácia no BrowseComp-Plus | 32,1% (GRPO 143K) / 37,1% (Resumo em texto) | 49,6% (Corpus BM25) | +17,5 pts / +12,5 pts |
| Taxa de Sequestro (Off-task Hijacking) | 57,9% (Montagem completa de KV) | 2,7% (Montagem apenas na atenção) | Redução de 21 vezes |
| Montagem de Prompt de 128K | 358,5 ms | 1,44 ms | 249 vezes mais rápido |
| Divergência KL (Rollout vs. Treino) | 0,0142 | 0,000445 ($4,45 \times 10^{-4}$) | 32 vezes menor |
Ao blindar os estados recorrentes e compartilhar apenas a memória associativa das camadas de atenção, o sistema reduz o sequestro de tarefa em 21 vezes (de 57,9% para 2,7%), retém 92,2% da informação mútua que estaria presente no texto completo e faz isso alocando exatamente zero páginas extras de KV físico na memória da GPU.
Crédito contrafactual: como treinar uma árvore sem achatá-la
Resolver a inferência é apenas metade da equação. Os frameworks de RL multiagentes existentes costumam falhar no momento da retropropagação (backpropagation) porque achatam as trajetórias em sequências independentes ou descartam as dependências entre ramos quando um agente lê o resultado de outro. Se o grafo de execução durante o coleta de dados (rollout) usa estados latentes montados, mas o treinador reconstrói tudo como texto plano desconectado, surge uma discrepância severa entre a política que gerou os dados e a política que está sendo atualizada.
O terceiro componente do framework, o Packed DAG-GRPO Trainer, elimina essa distorção empacotando todos os ramos de um episódio em uma única passagem de atenção esparsa em blocos (block-sparse attention pass) estruturada como uma árvore de prefixos. Como as arestas de KV montadas via read_thread permanecem diferenciáveis de ponta a ponta durante o passo de treinamento, a divergência KL entre rollout e treinamento cai 32 vezes, saindo de $0,0142$ para $4,45 \times 10^{-4}$.
Além disso, existe o problema clássico da atribuição de crédito em sistemas cooperativos: se cinco subagentes trabalharam em ramos diferentes e a resposta final do episódio foi correta, qual ramo realmente contribuiu e qual apenas gastou tokens em vão? O Octopus foi treinado sob recompensas binárias puras de resultado (0 ou 1 ao final do episódio, sem nenhuma modelagem artificial de processo) e resolve a distribuição de crédito de maneira contrafactual. Ele calcula recompensas marginais leave-one-branch-out (deixando um ramo de fora por vez) para medir exatamente o impacto que a ausência daquela ramificação teria no resultado final.
A prova mais contundente de que esse treinamento ensina uma habilidade genuína de coordenação espacial na memória, e não apenas uma memorização de fatos nos pesos da rede, está no teste de ablação sobre o mesmo checkpoint (Step-45). Usando exatamente os mesmos pesos treinados, avaliados em um conjunto pareado de 571 consultas do BrowseComp-Plus, o modelo atinge 50,8% de acurácia com suas primitivas ativas. Quando os pesquisadores simplesmente desligam a primitiva fork em tempo de teste, forçando esse mesmo cérebro a pensar em linha reta, a acurácia desaba 21,7 pontos percentuais, caindo para 29,1%. A inteligência demonstrada pelo modelo reside na topologia da execução.
Como inspecionar os artefatos e onde estão as fronteiras
Todo o ecossistema desenvolvido pelos pesquisadores foi disponibilizado publicamente sob licença Apache-2.0. O código do runtime de serving, gerenciador de memória e treinador está no repositório oficial do GitHub (abre em nova aba), enquanto o conjunto de dados de treinamento e avaliação pode ser baixado no Hugging Face (abre em nova aba).
Para desenvolvedores que desejam inspecionar a política treinada, os pesos divulgados em Tommysha/Octopus-Qwen3.5-4B (abre em nova aba) correspondem ao adaptador LoRA de Rank-64 no checkpoint Step-45 (1 época de DAG-GRPO recursivo). Embora o ganho real em produção dependa da execução conjunta com o motor modificado do SGLang que interpreta as chamadas de cursor na GPU, o adaptador pode ser carregado via biblioteca PEFT padrão para análise de pesos e estrutura:
from peft import PeftModel
from transformers import AutoModelForCausalLM

base_model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3.5-4B")
model = PeftModel.from_pretrained(base_model, "Tommysha/Octopus-Qwen3.5-4B")Ao avaliar o significado técnico do Octopus para o próximo ciclo de engenharia de IA, suas limitações de escopo são tão instrutivas quanto seus acertos. A primeira restrição está explícita no próprio subtítulo do projeto (One Brain, Many Branches): o compartilhamento de KV cache com cópia zero exige que todos os agentes compartilhem exatamente o mesmo backbone e os mesmos pesos de projeção. Você não pode montar o KV cache de um modelo especialista em código dentro das camadas de atenção de um modelo generalista de outra família; trata-se de paralelismo homogêneo, não de uma sociedade de modelos heterogêneos. A segunda restrição é o acoplamento profundo de infraestrutura: o desenvolvedor deixa de tratar o servidor de inferência como uma API HTTP stateless compatível com OpenAI e passa a gerenciar estados de sessão persistentes acoplados à memória física das GPUs.
Ainda assim, o julgamento técnico é inequívoco: o Octopus expõe a fragilidade da nossa obsessão atual por orquestradores multiagentes baseados em troca de texto e janelas lineares de milhões de tokens. Forçar cópias do mesmo modelo a conversar em linguagem natural para resolver uma tarefa de busca é um artefato de abstrações de software preguiçosas, não uma necessidade matemática. Ao demonstrar que um modelo de 4 bilhões de parâmetros pode superar arquiteturas até 250 vezes maiores simplesmente porque recebeu o direito de organizar sua memória de trabalho como uma árvore limpa e de compartilhar descobertas por telepatia tensorial nas camadas de atenção, este trabalho aponta para onde os próximos saltos de eficiência vão ocorrer. O futuro do raciocínio em tempo de teste não pertence a quem gera mais texto, mas a quem gerencia melhor os ponteiros da própria memória.