
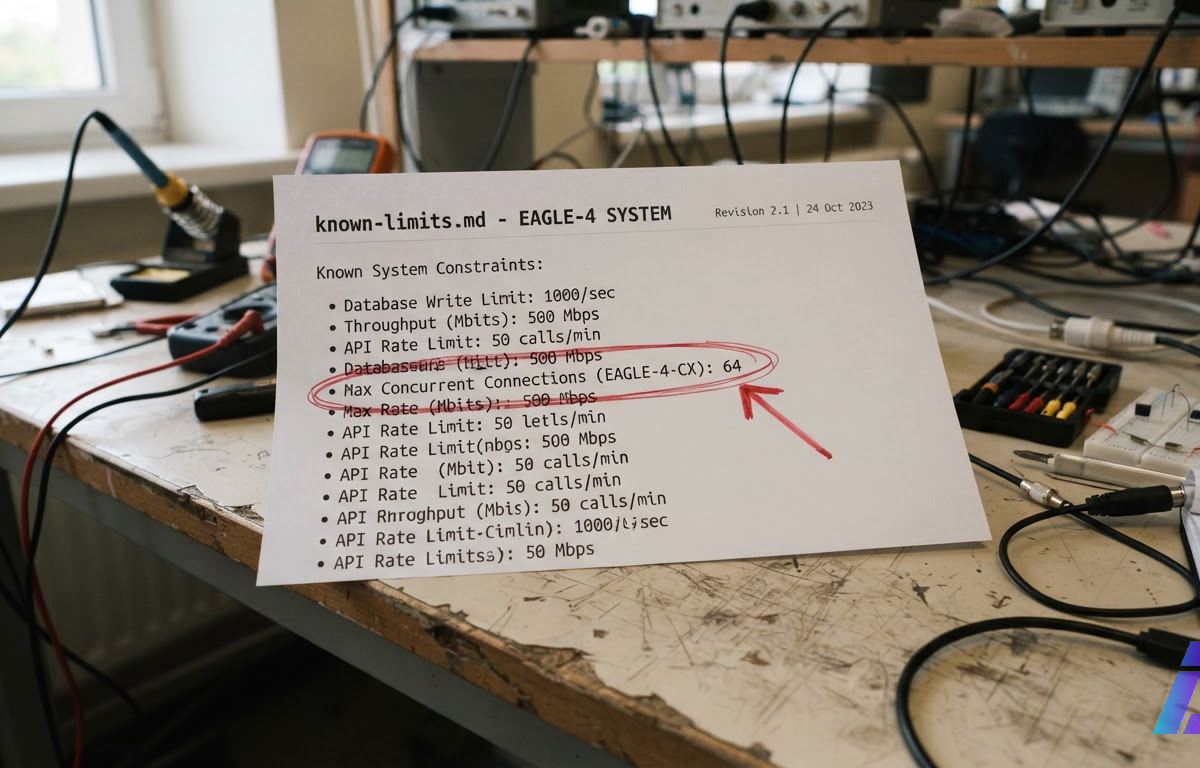
O EAGLE-4 chegou em 20 de outubro de 2026 com uma promessa curta: um único drafter treinado serviria tanto a requisição solitária quanto o servidor lotado, sem retreino e sem ajuste manual. A promessa está no subtítulo, One Flexible Drafter for All Batch Sizes and Hardware, e foi repetida no blog de lançamento e na cobertura que se seguiu. O curioso é que o documento mais honesto sobre o assunto também saiu do próprio projeto. Chama-se known-limits.md, foi verificado pela última vez em 21 de outubro, um dia depois do anúncio, e diz que a promessa não vale acima de concorrência 64.
Essa contradição é o centro da história. A comparação com o HyperQwen (abre em nova aba), da syv-ai, ajuda a vê-la melhor. A comparação de números diretos não ajuda, porque os dois projetos jogam em campeonatos diferentes.
De quem é o EAGLE-4
A primeira pergunta é de cartório. A família EAGLE (Extrapolation Algorithm for Greater Language-model Efficiency) tem casa conhecida: o repositório SafeAILab/EAGLE (abre em nova aba), que hospeda as implementações oficiais do EAGLE-1 (ICML'24), do EAGLE-2 (EMNLP'24) e do EAGLE-3 (NeurIPS'25). O README desse repositório lista um item "EAGLE-4" entre as atualizações, mas o branch principal continua sendo EAGLE-3 e EAGLE-2.
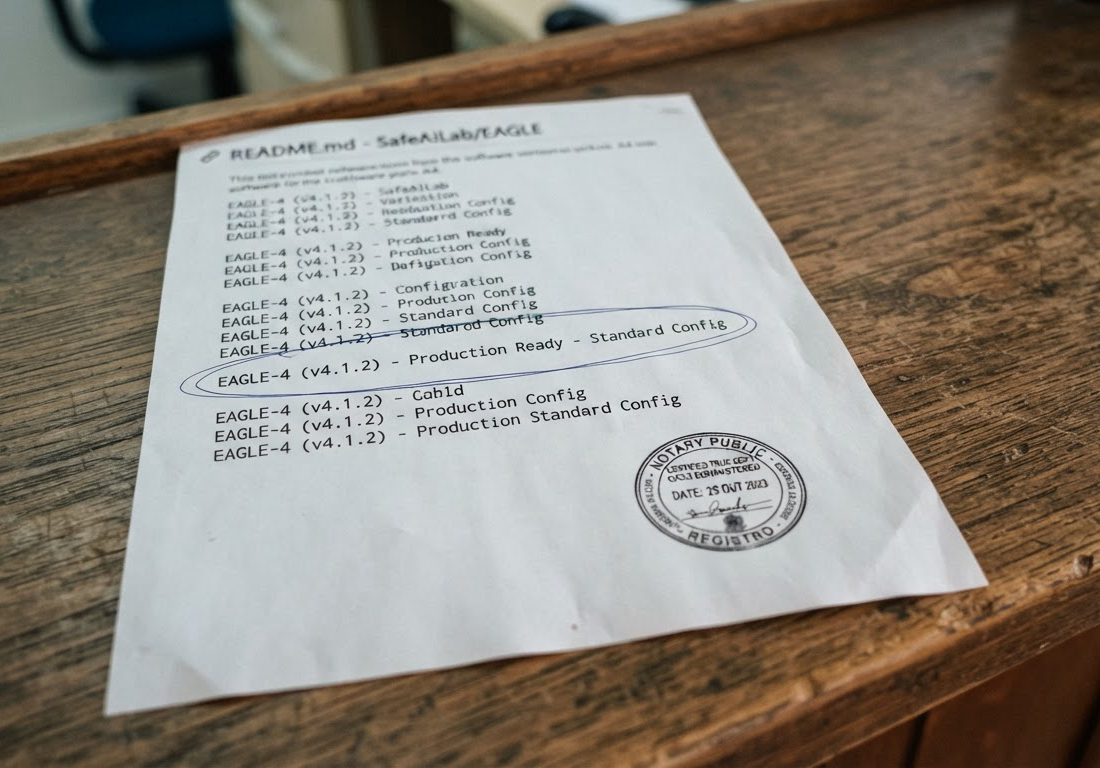
O código de inferência de 2026 vive em outro lugar, o eagle-hq/EAGLE-4 (abre em nova aba). O paper é um PDF dentro desse repositório, não um preprint no arXiv com assinaturas verificáveis, e os pesos ficam sob uma organização chamada EAGLE-corp no Hugging Face. O blog de lançamento é assinado genericamente por "Eagle Team". Nenhuma das informações publicadas amarra o eagle-hq aos autores dos três primeiros EAGLE. A menção no README do SafeAILab sugere continuidade, mas não a prova. Quem for colocar isso em produção deve tratar a linhagem como plausível e a autoria como não confirmada.
O que muda na arquitetura
Tecnicamente, o EAGLE-4 parte da ideia do EAGLE-3: um drafter leve combina hidden states do modelo-alvo com embeddings de tokens para prever continuações. A documentação de arquitetura descreve três mudanças concretas. O draft passa a usar uma camada com janela deslizante, um cache de draft append-only e uma "low-rank candidate head".
A terceira é a mais interessante, e o blog explica por quê. Os logits sobre o vocabulário inteiro consumiam 65,4% de um forward de draft de 574 μs. A solução foi uma estimativa de posto r que escolhe poucos candidatos por fatia do vocabulário. Só esses candidatos são pontuados de novo, exatamente, com as linhas completas da LM head. Em drafters pequenos, a cabeça de saída pesa mais que o corpo, e é ali que a equipe foi cortar.
O drafter do Qwen tem 0,44 bilhão de parâmetros em camadas Transformer, contra 1,66 bilhão do DFlash 2 e 1,65 bilhão do DSpark, segundo a tabela do blog.
A segunda novidade é um modelo de custo. O eagle-harness mede o custo de draft e o de verificação no hardware real e dimensiona a árvore especulativa a partir disso, para o lote e a carga em curso. A integração com o motor de serving se faz por hooks de plugin, sem patch em runtime. Os motores, porém, precisam ser versões modificadas e distribuídas como wheels fixas e imagens de contêiner. A documentação registra que "stock engines and unpinned packages do not carry the EAGLE-4 hooks". Em português de operação, você não usa seu vLLM de sempre.
Os números que o projeto publica
Há três conjuntos de números, e convém não misturá-los.
O primeiro vem do paper. Os testes rodaram com Qwen3.8-27B, 4× B300, TP4, temperatura 0, split qualitativo do SPEED-Bench e MegaKernel desativado. Nessas condições, o EAGLE-4 faria 863,8 tokens/s com uma requisição, contra 240,5 do vanilla (3,59×), e 28.340 tokens/s agregados com 512 requisições, contra 21.203 (1,34×). Na mesma tabela, DSpark e DFlash 2 caem abaixo do vanilla em 512. No Nemotron 3.5 Super VL, o paper reporta 647 tokens/s com uma requisição (2,74×) e 33.480 com 512 (1,69×).
O segundo é a matriz de suporte do release, medida com o código efetivamente distribuído, em média de duas subidas de servidor:
| Motor | GPUs | Concorrência | Sem spec (tok/s) | EAGLE-4 (tok/s) | Speedup |
|---|---|---|---|---|---|
| SGLang | 4× B300, TP4 | 8 | 1479,4 | 2820,6 | 1,91× |
| SGLang | 4× B300, TP4 | 64 | 3925,3 | 5281,3 | 1,35× |
| SGLang | 1× MI355X, TP1 | 8 | 552,7 | 1145,9 | 2,07× |
| SGLang | 1× MI355X, TP1 | 32 | 1269,2 | 1980,8 | 1,56× |
| vLLM | 4× B300, TP4 | 1 | 241,6 | 722,8 | 2,99× |
| vLLM | 4× B300, TP4 | 8 | 1699,9 | 2883,9 | 1,70× |
Repare onde a tabela para: em 64. Os 863,8 tokens/s do paper viraram 722,8 no vLLM do release com uma requisição. Não há linha de release em 512.
O terceiro conjunto é o da fal (abre em nova aba), em colaboração com a Fireworks, com 138 prompts da Fireworks e 400 de expansão criativa. Com uma requisição, o EAGLE-4 Harness faria 660,6 tokens/s no Fireworks Bench e 622,9 no SpecBench, 1,63× e 1,85× a alternativa mais rápida. Com concorrência 8, os números sobem para 3566,4 e 3551,9. É um terceiro ambiente de medição, mas não uma reprodução independente, porque a fal participou do lançamento. A reportagem do RITS da NYU Shanghai resumiu sem rodeio: nenhum desses resultados foi reproduzido de forma independente.
A limitação que o próprio projeto admite
Agora, o documento incômodo. O known-limits.md registra que, no SGLang com limite de 512 requisições em execução e árvore padrão em TP4, o EAGLE-4 mediu 1,03× o mesmo motor sem especulação na concorrência 64. Na 256, foram 0,74×. Na 512, 0,61×, com três subidas cada. A recomendação vem por extenso: "Serve concurrency above 64 without speculation for now". A política automática para alta carga continua desligada por padrão.
Releia o subtítulo do projeto à luz dessa frase. O drafter que seria bom para todos os tamanhos de lote, no código que você baixa hoje, perde 39% de throughput em 512. Esse é exatamente o regime em que o paper o mostra 34% à frente do vanilla e onde a cobertura dizia que os concorrentes "colapsam".
Existe uma explicação alternativa, e as fontes a sustentam em parte. O paper mede com MegaKernel desativado e numa configuração própria. O release mede com motores reais, limite de execução, árvore padrão e política de alta carga desligada. A diferença pode estar no dimensionamento automático da árvore, que é justamente a novidade do método e ainda não está ligada por padrão. É uma hipótese razoável, mas nenhuma fonte a demonstra. O que está demonstrado é mais modesto: em concorrência baixa e média, de 1 a 64, nos hardwares testados, há ganho real e medido pelo release. Acima disso, ou o ganho existe só no paper, ou depende de uma política que o projeto ainda não liberou.
A lista de ressalvas continua:
- Correção greedy: no vLLM TP4 com concorrência 64, um prompt pode escolher outro token numa posição, a até 5,4 ULP bf16 da escolha fp32, acima da regra de 2 ULP. O desvio apareceu em 3 de 6 subidas com a versão 0.1.1. A concordância greedy em 512 não é alegada. A arquitetura avisa que descreve o algoritmo, não uma prova de equivalência de distribuição em toda implementação.
- Nemotron: a comparação no SGLang tem divergências pendentes, e os resultados de vLLM e TokenSpeed estão "em progresso". Os números do Nemotron no blog, portanto, não têm contrapartida no release.
- Hardware: as medições de serving cobrem B300 e MI355X no SGLang. Compilar para outra arquitetura é, nas palavras do projeto, "evidência separada". Multinó e pipeline parallelism ainda estão em qualificação.
- Funcionalidades: a verificação em árvore do vLLM exige KV cache não quantizado. O SGLang recusa imagens. O TokenSpeed é experimental, só roda em CUDA, ainda não tem tabelas de custo e não tem throughput alegado.
Há mérito em publicar tudo isso. Pouca gente põe no próprio repositório a linha que contradiz o marketing. O mérito, porém, não apaga o fato.
Onde entra o HyperQwen
O HyperQwen é outra coisa. Ele não traz um algoritmo de drafting novo. É um pacote para servir o mesmo Qwen3.8-27B numa única GPU de consumo de 24 GB, com vLLM 0.31.0 fixado, contexto de até 150 mil tokens e API compatível com OpenAI. Todos os números são de uma RTX 3090 a 250 W:
- 127 tok/s em stream único no modo single-user, com 64k de contexto;
- cerca de 1.035 tok/s agregados com 64 concorrentes no modo batch (128 de entrada, 512 de saída);
- 381 tok/s quando a resposta cita o próprio prompt;
- 95 a 100 tok/s com 150k de contexto via MTP.
O modo single propõe 7 drafts por passada e verifica 15 tokens por passo a partir do contexto. O batch usa estado recorrente em 16 bits e GEMMs int8.
A frase mais útil do repositório é esta: "Speculation wins below ~8 concurrent users, plain batching above". Por isso o projeto oferece dois modos, e uma GPU roda um de cada vez. É a admissão, por arquitetura, do mesmo problema que o EAGLE-4 diz ter resolvido e que o known-limits mostra ainda não resolvido acima de 64.
Os números não são comparáveis. Mudam o hardware (3090 contra 4× B300 ou MI355X), a quantização (requantização int8 contra BF16), o benchmark e o tipo de carga. Colocar 127 ao lado de 722,8 num gráfico seria comparar uma bicicleta com um caminhão pelo velocímetro. O que se compara é a filosofia. O EAGLE-4 aposta num drafter treinado e num modelo de custo que decide sozinho. O HyperQwen aposta em escolha explícita do operador e otimização agressiva para um único alvo.
O HyperQwen também tem ressalvas próprias. O kernel de prefill int8-QK só funciona com num_heads == 24, num_kv_heads == 4 e head_size == 256, ou seja, com a forma exata desse modelo. As tabelas Marlin foram medidas em sm86, e sm80 tem uma falha de especulação em aberto. A licença é Apache-2.0. O HyperQwen também não tem reprodução externa citada.
O que está provado e o que falta
Demonstrado pelo próprio release: ganhos entre 1,35× e 2,99× contra o mesmo motor sem especulação, de concorrência 1 a 64, em B300 e MI355X, com Qwen3.8-27B a temperatura 0. Também está demonstrada a perda abaixo do vanilla em 256 e 512 no SGLang.
Alegado e não reproduzido: os números do paper em 512 requisições, o Nemotron, CPU e celular. O blog cita 2,28× a 2,92× num Gemma-4-E2B de 4 bits em llama.cpp numa AWS c5.xlarge, e 3,62× em HumanEval no telefone, mas nada disso aparece na matriz do release.
Em aberto: a autoria e o vínculo com o SafeAILab, a equivalência de distribuição fora do greedy, o comportamento em temperatura maior que zero, GPUs que não sejam B300 ou MI355X, outros modelos-alvo além do par Qwen medido e qualquer integração nos pacotes oficiais de vLLM, SGLang ou TensorRT-LLM. Por ora, só existem forks fixados.
Julgamento
O EAGLE-4 é um avanço técnico crível em um ponto específico: a cabeça de candidatos de baixo posto ataca um custo real, documentado em microssegundos, e o drafter ficou menor que os concorrentes. Para quem serve Qwen3.8-27B em B300 ou MI355X com até 64 requisições simultâneas, vale testar, com os ganhos que o release mede, não os do paper.
A tese que dá nome ao projeto, porém, não está comprovada. Ela está refutada pelo próprio código no regime que mais importa para quem paga a conta de inferência em escala. Quem roda servidor carregado deve seguir a recomendação do próprio projeto e desligar a especulação acima de 64.
O HyperQwen, mais modesto, chegou à conclusão correta antes: até que alguém prove o contrário com medição reproduzível, especulação e batching pesado ainda são modos diferentes de operar, e não um só.