Modelos de inteligência artificial baseados em arquiteturas densas e esparsas (Mixture of Experts ou MoE) exigem, tradicionalmente, servidores com múltiplas placas de nível corporativo e centenas de gigabytes de VRAM para manter seus parâmetros alocados. Essa barreira de infraestrutura inviabiliza o auto-hospedamento de sistemas de parâmetros elevados por pequenas equipes de desenvolvimento e estações de trabalho convencionais.
O Strata (abre em nova aba) é um motor de inferência de código aberto, licenciado sob a licença MIT, projetado expressamente para contornar essa restrição física. Ao distribuir camadas críticas de cálculo, tensores de roteamento, buffers temporários e redes de especialistas entre a VRAM da GPU, a memória RAM do computador e o armazenamento em SSD, a ferramenta permite executar modelos MoE como o Qwen3.8-Flash-Next (de 125 bilhões de parâmetros totais) em placas domésticas comuns de 12 GB de memória gráfica.
Para quem é este guia
Este guia foi elaborado para engenheiros de software, pesquisadores de aprendizado de máquina e profissionais de infraestrutura técnica que precisam executar modelos abertos extensos diretamente em hardware de mesa sem depender de APIs de terceiros.
Ao final desta leitura, você saberá:
- Compreender detalhadamente o mecanismo de orquestração de memória de quatro níveis empregado pelo Strata.
- Configurar e instalar o motor no Linux ou Windows em máquinas com 12 GB de VRAM e pelo menos 32 GB de RAM.
- Selecionar a quantização correta conforme a sua dotação física de memória e ativar, quando necessário, o modo de baixa memória (
low-RAM mode). - Inicializar a interface compatível com OpenAI do Strata e integrá-la a scripts de automação ou sistemas locais.
Pré-requisitos
O que você vai construir
Você colocará em operação um endpoint local servindo o modelo MoE Qwen3.8-Flash-Next, orquestrado pelo Strata, que escuta conexões HTTP padrão de inferência na porta 8080. O sistema expõe o protocolo oficial compatível com a API v1 da OpenAI (http://127.0.0.1:8080/v1), respondendo a requisições de geração textual, completude de tarefas de código e chamadas automatizadas, tirando proveito de acelerações SIMD como AVX-512 ou AVX2 no processador em conjunto com a aceleração gráfica.
Como o Strata otimiza a memória (VRAM, RAM e SSD)
Para compreender por que modelos de 125 bilhões de parâmetros conseguem ser executados sob placas com apenas 12 GB de VRAM, é necessário avaliar a estrutura esparsa do modelo. O Qwen3.8-Flash-Next organiza sua rede neural em 24.576 "especialistas" (experts), dos quais apenas cerca de 10 são ativados dinamicamente para processar cada token individual gerado.
Em vez de manter todos os parâmetros alocados na placa gráfica, o Strata implementa um pipeline estratificado:
- GPU (VRAM): Mantém os tensores essenciais de baixa latência, incluindo matrizes de atenção (attention/DeltaNet mixers), roteadores de especialistas (routers), especialistas compartilhados (shared experts), cabeça de saída do modelo (output head), camadas de rascunho de especulação Multi-Token Prediction (MTP) e uma fatia dinâmica do cache de chaves e valores (KV cache, particionado da janela de contexto de até 64K tokens). O restante da VRAM não consumida é atribuído a um cache adaptativo de especialistas, acomodando cerca de 700 especialistas para cada gigabyte livre.
- Memória principal (RAM): Fixa (pinned memory) os tensores dos 24.576 especialistas. Os especialistas que não cabem no cache da VRAM da GPU são executados diretamente pelo processador do computador, utilizando implementações nativas e núcleos paralelos com extensões vetoriais como AVX-512 VNNI, AVX2 e bibliotecas herdadas de cálculo de matrizes como ggml. Esse processamento ocorre simultaneamente com os cálculos executados na GPU.
- Armazenamento (SSD): Mantém índices fixos de decodificação preditiva, como uma tabela de n-gramas de 28,8 GB, da qual poucas linhas são lidas por token gerado. No chamado modo de baixa memória (
low-RAM mode), se o sistema não possuir memória física suficiente para fixar todos os pesos dos especialistas, o motor faz a leitura e mapeamento de especialistas não alocados a partir de arquivos no SSD sob demanda via paginação do sistema de arquivos.
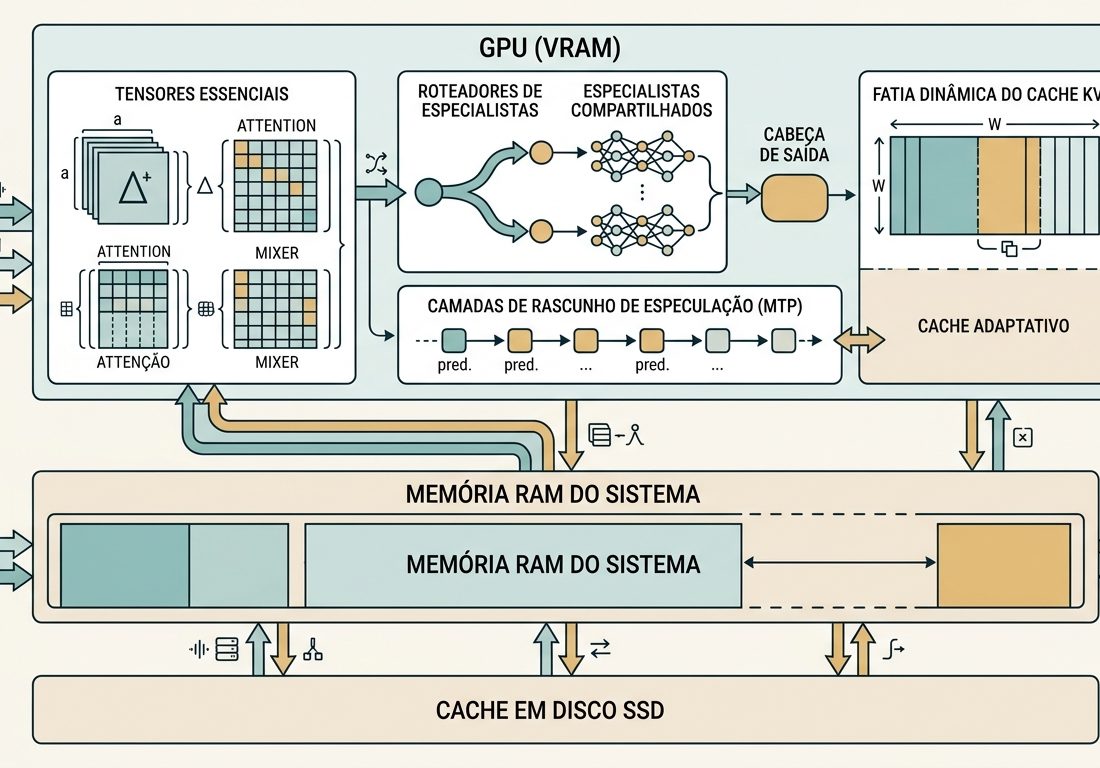
A especulação multi-token (MTP) permite que o Strata gere previamente rascunhos de até 3 tokens subsequentes por meio de um cabeçote auxiliar, validando-os em uma única passagem de inferência pela rede principal, elevando a velocidade de decodificação entre 1,6x e 1,8x sem perda de acurácia matemática.
Comparativo: Strata vs. Llama.cpp e Ollama
Ferramentas amplamente adotadas no ecossistema local, como o llama.cpp (abre em nova aba) e o Ollama (abre em nova aba), foram arquitetadas primordialmente para modelos densos unificados ou descarregamento linear de camadas (layer-by-layer offloading). Ao lidar com modelos massivos do tipo MoE, tais mecanismos sofrem com gargalos estruturais de transferência pelo barramento PCI Express.
| Característica | Strata | Llama.cpp | Ollama |
|---|---|---|---|
| Estratégia de partição MoE | Mantém roteadores e hot-experts na GPU; computa o restante em RAM com CPU em paralelo | Descarrega camadas completas na GPU ou exige cópia de especialistas via PCIe | Envoltório do llama.cpp; divisão sequencial por camadas inteiras |
| Execução concorrente CPU/GPU | Sim (CPU calcula especialistas frios enquanto GPU calcula atenção) | Sequencial por camada ou dependente de pipeline linear | Sequencial |
| Suporte nativo a SSD Streaming | Sim (low-RAM mode sob demanda mapeado do disco) | Dependente de swap do SO (resulta em queda drástica) | Dependente de swap do SO |
| Especulação nativa (MTP) | Integrada (draft de até 3 tokens) | Suporte experimental via modelos de draft separados | Dependente da engine base |
| Desempenho em 125B MoE (12 GB GPU + 64 GB RAM) | ~53 a 94 tokens/s (dependendo da quantização) | ~10 tokens/s na mesma classe de parâmetros | ~10 tokens/s |
Em medições laboratoriais de comunidade sobre uma placa RTX 5060 Ti, o Strata atingiu entre 57 e 68 tokens/s na quantização Q2_0 operando com 64 GB de RAM física, superando em cerca de 6 vezes a velocidade do llama.cpp na mesma carga (aproximadamente 10 tokens/s). Mesmo ao restringir o hardware a 32 GB de RAM forçando o fluxo via SSD, o Strata registrou 19 tokens/s, mantendo o dobro da cadência do motor convencional.
Passo a passo
Siga os procedimentos abaixo de forma sequencial para preparar o ambiente de arquivos, executar o utilitário de configuração automatizada e carregar os pesos do modelo correspondente à capacidade do seu computador.
Passo 1 — Clonar o repositório oficial do Strata
Abra o terminal do seu sistema operacional e baixe a estrutura de código-fonte oficial mantida no GitHub.
# Clona o repositório do Strata localmente
git clone https://github.com/Niko1221/Strata.git

# Acessa o diretório do projeto clonado
cd Strata
O repositório contém os scripts unificados de inicialização para Linux (setup.sh) e Windows (START-HERE.bat), bem como a lógica de verificação de barramento e módulos de inferência.
Passo 2 — Planejar o nível de quantização conforme a memória RAM
Antes de disparar o download de dezenas de gigabytes, avalie a quantidade de memória RAM disponível na placa-mãe do seu sistema para evitar estouros de memória física.
| Memória RAM instalada | Modelo / Quantização recomendada | Espaço total alocado (RAM + VRAM) | Perfil de desempenho e finalidade |
|---|---|---|---|
| 32 GB | Coder (shard 1) | ~29.6 GB | Mantém 256 de 512 especialistas por camada. Otimizado para programação (91% SWE-bench Verified). |
| 48 GB | Q2_0 ou IQ2_XS | 37.6 GB a 39.2 GB | Q2_0 é o mais veloz (AVX-512 VNNI). IQ2_XS oferece qualidade superior com pouca perda de velocidade. |
| 64 GB | IQ2_XS, IQ3_XXS ou IQ3_S | 39.2 GB a 54.8 GB | 64 GB suporta todas as variantes. IQ3_S entrega a maior fidelidade textual em relação ao modelo pleno. |
| 96 GB ou mais | IQ3_S ou Unsloth 4-bit | 54.8 GB+ | Execução integral com alocação máxima de cache sem descarte de especialistas. |
Passo 3 — Executar a rotina de preparação e download
O utilitário de instalação inspeciona o hardware local (detectando a arquitetura do processador, VRAM disponível e RAM de sistema) e conduz a aquisição dos pesos quantizados do Qwen3.8-Flash-Next e da rede de rascunho MTP (~6 GB).
No ambiente Linux:
# Torna o script executável caso ainda não possua privilégios
chmod +x setup.sh

# Executa o assistente de configuração automática
./setup.sh
No ambiente Windows (executado via Prompt de Comando ou PowerShell):
REM Dispara o processo interativo de preparação
START-HERE.bat
Durante o assistente, o sistema exibirá as variantes disponíveis para download com base na análise de memória. Caso esteja operando em uma máquina de 32 GB ou 46 GB e o script recuse o perfil padrão de quantização, você pode forçar explicitamente a flag de controle de baixa memória.
Para sobrescrever a verificação automática de limites de memória caso necessário:
# Executa a configuração forçando ativação explícita do modo low-ram
./setup.sh --setup --low-ram on
No Windows:
REM Ativa manualmente o low-ram mode via arquivo em lote
START-HERE.bat --setup --low-ram on
Passo 4 — Ajustar variáveis de compatibilidade do ambiente
Alguns ambientes com compiladores específicos ou instruções de fusão podem gerar inconsistências na leitura dos kernels acelerados. Uma instrução relevante compartilhada pelo autor e desenvolvedor do projeto, Niko Veit (@coldniko), orienta o ajuste de fusão de operações via arquivo de ambiente caso ocorram falhas de estabilidade:
STRATA_PF_FUSED=0 no .env Me avise se voltar atrás. Se voltar abra um PR
Para aplicar o ajuste de configuração caso se depare com erros de cálculo nos operadores:
# Adiciona a diretiva desativando a fusão de operadores no ambiente local
echo "STRATA_PF_FUSED=0" >> .env
Passo 5 — Inicializar o servidor de inferência local
Com os tensores do modelo descarregados e o cache de n-gramas posicionado no SSD, inicie o serviço do Strata. O processo aloca os buffers primários na GPU, fixa a malha de tensores na memória RAM e sobe a porta HTTP de atendimento.
No Linux:
# Inicia a execução do servidor
./setup.sh --start
No Windows:
REM Inicializa o backend do servidor de modelos
START-HERE.bat --start
Ao concluir a carga de pesos na VRAM e memória de sistema, o terminal confirmará que o servidor HTTP está pronto para receber conexões na interface de rede padrão, escutando no endereço http://127.0.0.1:8080.
Como verificar se funcionou
Para testar se o motor alocou corretamente a memória e está respondendo às chamadas com o modelo de especulação ativo, abra outro terminal e execute uma requisição utilizando o utilitário curl voltada ao endpoint de completude de chat:
# Envia uma solicitação de inferência estruturada em JSON
curl -X POST http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "default",
    "messages": [
      {"role": "system", "content": "Você é um assistente técnico conciso."},
      {"role": "user", "content": "Escreva um algoritmo de ordenação rápida (QuickSort) em Python puro."}
    ],
    "temperature": 0.2
  }'
Se o motor estiver operando como esperado, você receberá como resposta um objeto JSON contendo o campo "choices" com o texto gerado e a métrica de tokens processados nos campos de estatística (usage).
Você também pode verificar o consumo de recursos computacionais durante o processamento em um terminal adjacente:
- No Linux: execute
nvidia-smipara conferir a ocupação da GPU (deve estabilizar perto do limite da VRAM, deixando uma reserva de segurança em torno de 300 MiB) efree -hpara verificar a quantidade de RAM física bloqueada pelos especialistas. - No Windows: utilize o Gerenciador de Tarefas para conferir a alocação fixa de memória compartilhada e uso de CPU nos vetores AVX-512/AVX2.
Erros comuns e soluções
O instalador recusa o modelo informando memória insuficiente
- Problema: Ao selecionar variantes como
IQ3_XXSem máquinas com menos de 60 GB de RAM livres, o assistente emite um alerta de memória insuficiente e aborta ou regride para perfis menores. - Solução: Force o sinalizador de baixa memória passando o parâmetro
--low-ram onno instalador (./setup.sh --setup --low-ram onouSTART-HERE.bat --setup --low-ram on). Isso permite que o motor utilize o cache de arquivos do sistema operacional para os especialistas que excederem a capacidade física da RAM, recorrendo ao SSD. Como alternativa ideal para máquinas restritas a 32 GB, selecione a varianteCoder(aproximadamente 29,6 GB de RAM ocupada) que desliga parte dos especialistas não essenciais.
Falhas de alocação de VRAM (CUDA out of memory)
- Problema: A placa de vídeo encerra a execução repentinamente ao processar prompts longos ou carregar os tensores de atenção.
- Solução: Versões recentes do Strata (a partir da v0.1.38) ajustaram a reserva mínima de VRAM para cerca de 300 MiB a fim de acomodar placas de 12 GB no limite da capacidade. Caso utilize monitores de alta resolução conectados diretamente na mesma GPU dedicada, o consumo gráfico do sistema operacional pode invadir esse espaço. Reduza a resolução de saída, encerre navegadores com aceleração por hardware ou configure a flag de inicialização para limitar o contexto máximo caso o prompt ultrapasse limites volumosos de alocação de KV cache.
Queda severa na taxa de geração (tokens por segundo muito baixos)
- Problema: O modelo gera texto entre 15 e 20 tokens/s em vez dos ~60 a 90 tokens/s divulgados para setups equivalentes.
- Solução: Esta variação ocorre frequentemente quando o hardware cai na paginação em disco (
low-RAM mode). Em 32 GB de RAM, medições técnicas mostram que a leitura frequente de especialistas do SSD derruba o ritmo em cerca de 3 vezes em relação a máquinas de 64 GB de RAM com todos os pesos mantidos na memória principal. Além disso, verifique se seu processador oferece suporte a AVX-512 VNNI: a quantizaçãoQ2_0utiliza prioritariamente esses núcleos de cálculo paralelo vetorial na CPU.
Próximos passos
Com o ambiente local do Strata ativo e respondendo na porta 8080, você possui um ambiente privado capaz de processar tarefas de alta complexidade com modelos abertos de centenas de bilhões de parâmetros em sua própria infraestrutura.
Como evolução técnica do seu ambiente de trabalho:
- Integração com ecossistemas de agentes: Aponte bibliotecas compatíveis com a API OpenAI (como LangChain, LlamaIndex ou SDKs oficiais de Python) mudando o atributo
base_urlparahttp://127.0.0.1:8080/v1com qualquer chave de autorização fictícia configurada. - Interfaces visuais: Conecte o endpoint a interfaces de chat como Open WebUI para viabilizar atendimento textual e suporte multimodal em computadores da sua rede corporativa ou doméstica.
- Avaliação de contexto e tarefas: Teste prompts extensos com até 8.192 tokens para mensurar a resposta dos módulos de leitura de prompt de alta performance do Strata frente ao gargalo de barramento do seu hardware.