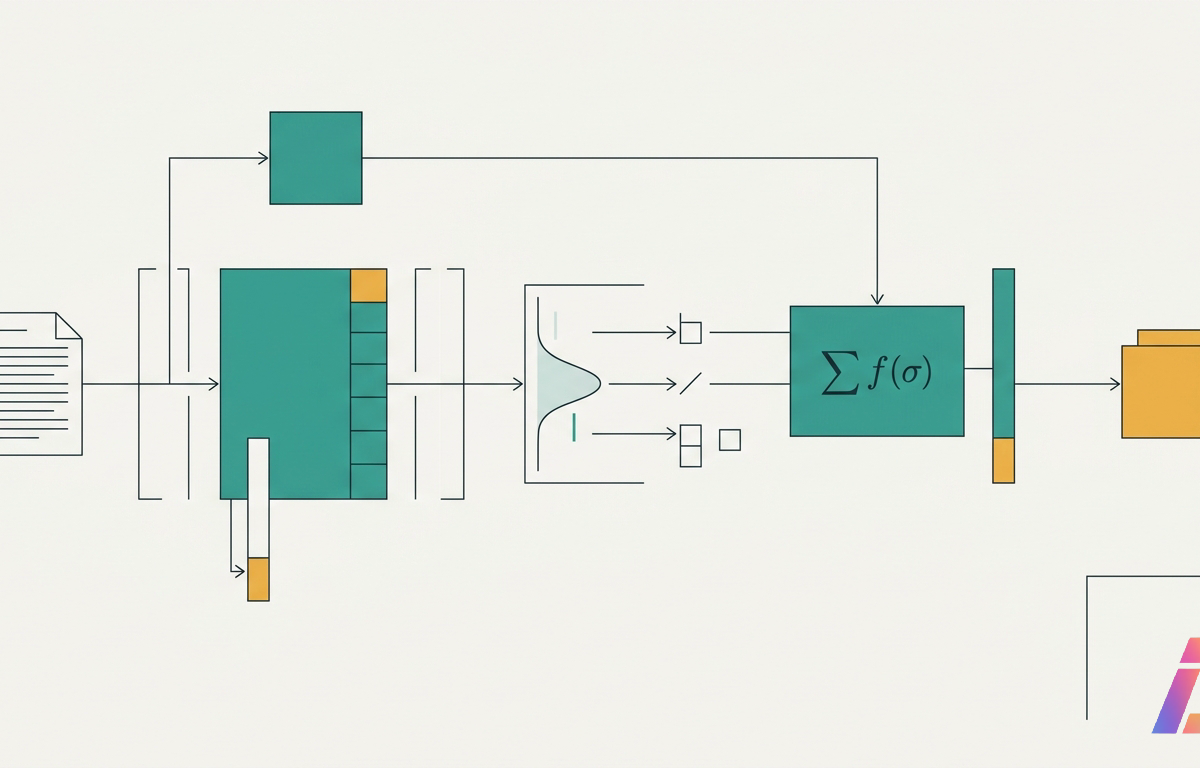
A identificação da origem de conteúdos sintéticos gerados por inteligência artificial tornou-se uma exigência jurídica com a vigência do EU AI Act. Para atender a essas diretrizes e aos compromissos firmados no EU Code of Practice on Transparency of AI-Generated Content, a OpenAI desenvolveu o textGrain (abre em nova aba), uma tecnologia voltada a inserir marcas d'água invisíveis diretamente no processo de amostragem probabilística de modelos de linguagem. Diferente de abordagens primitivas que injetam caracteres ocultos, pontuações atípicas ou espaços de largura zero na cadeia de saída, o método ancora sua operação na manipulação sutil das probabilidades de seleção de cada token gerado.
Esse ajuste matemático modifica a aleatoriedade utilizada pelo sistema ao escolher palavras ou fragmentos de palavras, denominados subpalavras. O resultado é a formação de um sinal estatístico disperso ao longo do texto. Esse sinal permanece imperceptível aos leitores humanos, mas pode ser verificado posteriormente por um software de detecção projetado para essa função.
Formulação matemática e transporte ótimo
A ideia de que basta enviesar levemente a distribuição de probabilidade para marcar um texto com segurança esbarra em limitações teóricas graves. Sem uma restrição formal, distorções arbitrárias degradam a coerência semântica ou facilitam ataques de remoção estatística. Para contornar essa fragilidade, o relatório técnico do textGrain (abre em nova aba), assinado por pesquisadores da Universidade da Pensilvânia, da Universidade de Yale e da OpenAI, estrutura a geração de texto como um problema de transporte ótimo.
O algoritmo acopla a geração dos tokens a uma aleatoriedade chaveada (keyed randomness), controlada por meio de uma chave secreta. O acoplamento probabilístico é resolvido a partir de custos formulados com variáveis aleatórias Gumbel combinadas a uma regularização por divergência de Kullback-Leibler (KL). A divergência de Kullback-Leibler mede a diferença relativa entre distribuições de probabilidade. Nessa arquitetura, a divergência KL em relação à independência equivale rigorosamente à redução na entropia condicional da amostragem. Essa equivalência matemática confere ao parâmetro de força da marca d'água uma interpretação transparente fundamentada na teoria da informação.
A aplicação direta desse transporte ótimo em vocabulários inteiros contendo dezenas de milhares de entradas criaria uma sobrecarga computacional intolerável durante a inferência. Para mitigar o custo temporal por token, o método divide o vocabulário em blocos. O transporte ótimo é calculado estritamente entre esses blocos, o que reduz substancialmente a dimensionalidade da otimização matricial. Dentro de cada bloco de vocabulário, as probabilidades relativas originais dos tokens são mantidas inalteradas, preservando o equilíbrio léxico local sem prejudicar o sinal global.
Um elemento operacional chave reside no desacoplamento entre geração e verificação. O operador do sistema define um orçamento de perda de entropia para calibrar o sinal no momento da inferência. Por outro lado, o detector precisa exclusivamente do texto suspeito e da chave criptográfica secreta, operando de maneira agnóstica em relação ao orçamento de entropia configurado originalmente na geração.
Desempenho e benchmarks empíricos
A viabilidade técnica de uma marca d'água depende do equilíbrio entre a capacidade de detecção do sinal e a preservação da qualidade original da escrita. De acordo com as avaliações publicadas pela desenvolvedora, o textGrain atingiu ou superou os resultados de métodos de referência no setor, incluindo o SynthID para texto. Em testes conduzidos com o Astra, modelo de fronteira da organização, o impacto da técnica na qualidade das tarefas avaliadas nos benchmarks padrão não apresentou variações de desempenho estatisticamente significativas.
A confiabilidade da detecção, todavia, depende diretamente do volume de texto fornecido. Em ensaios parametrizados para fixar a taxa de falsos positivos em um teto estrito de 1%, a eficácia da identificação oscilou com base na extensão da passagem analisada e na área de conhecimento do conteúdo:
| Domínio de Conteúdo | Extensão da Amostra (Tokens) | Taxa Alvo de Falsos Positivos | Eficácia de Detecção |
|---|---|---|---|
| Psicologia | 200 | 1% | ~80% |
| Psicologia | 400 | 1% | ~95% |
| Matemática | Variável | 1% | Substancialmente menor |
Textos pertencentes a campos com baixa entropia inerente sofrem restrições funcionais. É plausível que a baixa eficácia em matemática decorra da rigidez estrutural da sintaxe e da terminologia técnica, que impedem a redistribuição probabilística de palavras sem gerar erros conceituais. Também é igualmente sustentável a hipótese de que a brevidade intrínseca de demonstrações e fórmulas reduza o espaço amostral necessário para a detecção do sinal acumulado.
Limitações de robustez e edições pós-processamento
O sinal embutido nas palavras não é invulnerável a transformações superficiais executadas após a geração. Conforme intervenções manuais ou reescritas automatizadas substituem termos da cadeia original, o padrão estatístico acumulado dilui-se de forma acentuada.
Em avaliações de robustez aplicadas sobre blocos de 400 tokens, a acurácia de detecção degradou-se conforme intervenções por substituição de vocábulos eram introduzidas:
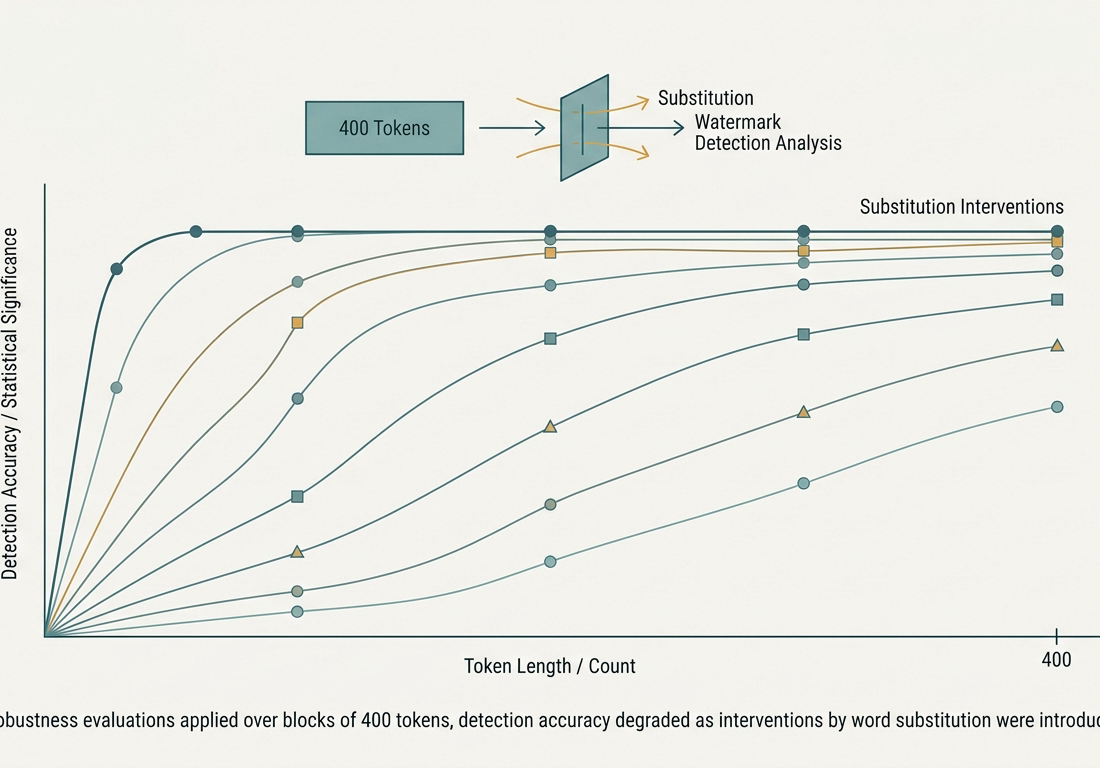
- Passagem de 400 tokens sem modificações: detecção em cerca de 92%.
- Substituição de 10% dos termos por sinônimos: detecção reduzida para 66%.
- Substituição de 25% dos termos por sinônimos: detecção colapsada para 17%.
Essa vulnerabilidade sob baixas contagens de tokens ou diante de reescritas motivou a OpenAI a restringir o uso do detector em seu lançamento inicial. O acesso ao verificador é concedido temporariamente apenas a pesquisadores aprovados e entidades especializadas, mediante submissão de casos de uso qualificados.
Integração operacional e implementação para desenvolvedores
A introdução do textGrain delineia um modelo operacional assimétrico entre os produtos de consumo final e a interface para desenvolvedores. Na União Europeia, a marca d'água invisível passou a ser aplicada progressivamente aos textos gerados no ChatGPT e no Codex. Esse direcionamento atende às diretrizes do artigo de transparência do Help Center (abre em nova aba) para conformidade com a regulamentação comunitária.
Nos serviços providos via API comercial, o textGrain permanece desligado por padrão em escala global. As equipes de engenharia podem adotar a funcionalidade de modo voluntário por meio do painel de controle, com suporte para ativação por projeto específico ou estendida a toda a organização corporativa. Essa flexibilidade atende a fluxos nos quais a procedência necessita ser demonstrada contratualmente sem impor limitações desnecessárias a pipelines automatizados de computação interna.
O posicionamento institucional sobre a iniciativa foi sintetizado pela empresa por meio de um comunicado público oficial detalhando as motivações regulatórias e os limites do sistema.
Estamos expandindo nossa abordagem de procedência de conteúdo para incluir texto em resposta aos requisitos regulatórios da UE, ao mesmo tempo em que reconhecemos as limitações significativas da tecnologia atual de marcas d'água em texto. Nossas ferramentas já ajudam a verificar se um arquivo de imagem ou áudio foi criado com nossos modelos. Este trabalho se baseia nesses esforços para ajudar as pessoas a entenderem melhor quando um conteúdo pode ter sido gerado ou editado com um modelo da OpenAI. Na UE, começaremos a aplicar marcas d'água em textos qualificados do ChatGPT e Codex ao longo das próximas semanas para cumprir o EU AI Act. Clientes que utilizam nossa API podem ativar marcas d'água em texto para modelos selecionados em todo o mundo hoje.
A estratégia técnica compõe uma estrutura em camadas para verificação de procedência. Essa camada combina a marca d'água estatística interna ao uso de metadados criptográficos externos, como os padrões da Coalition for Content Provenance and Authenticity (C2PA). O ecossistema planeja a publicação futura do código da tecnologia em formato de código aberto, abrindo o método de otimização de transporte para auditorias independentes da comunidade.
Com o avanço dos cronogramas regulatórios na Europa, a adoção de técnicas como o textGrain reflete a transição dos modelos de linguagem para ambientes com rastreabilidade estatística obrigatória. Essa rastreabilidade, contudo, permanece restrita a textos com pelo menos algumas centenas de palavras que preservem grande parte do vocabulário gerado originalmente.