
Em uma amostra de 100 gravações de sessão (session replays, registros que reproduzem a interação real das pessoas na tela) na página inicial da Amplitude (abre em nova aba), 80 usuários digitaram suas próprias perguntas do zero. Apenas 12 clicaram nos cartões de sugestão prontos na interface. Quase ninguém clicava. Em uma esteira tradicional de engenharia, transformar esse diagnóstico em código testado em produção levava coisa de um mês. Segundo um estudo de caso publicado pela OpenAI (abre em nova aba) em 12 de novembro de 2026, data em que a ferramenta foi lançada comercialmente para clientes da plataforma de análise, o agente proativo de produto Wave reduziu esse ciclo estimado para 1 a 2 dias. Todos os números de desempenho e custo disponíveis até aqui vêm de testes internos e relatos das duas empresas envolvidas, sem auditoria independente de terceiros.
Ter dados de sobra raramente resolve a lentidão de entrega. Ferramentas de análise acumulam gráficos enquanto uma mudancinha de interface espera semanas por triagem, especificação e desenvolvimento. A proposta técnica do Wave parte da observação desse gargalo para testar uma hipótese arquitetural: um sistema de agentes consegue fechar o ciclo entre a métrica estagnada e o deploy se não tentar fazer tudo em um único passo nem com um único modelo.
Da observação do erro ao plano técnico para agentes de código
Na arquitetura descrita pela Amplitude, a equipe humana começa definindo uma área do produto e as metas ou métricas que precisa movimentar. Em vez de gerar mais um relatório estático para um gerente ler na semana seguinte, o Wave cruza quatro fontes de contexto: eventos analíticos da plataforma, gravações de sessão, relatos de clientes e o código-fonte do repositório.
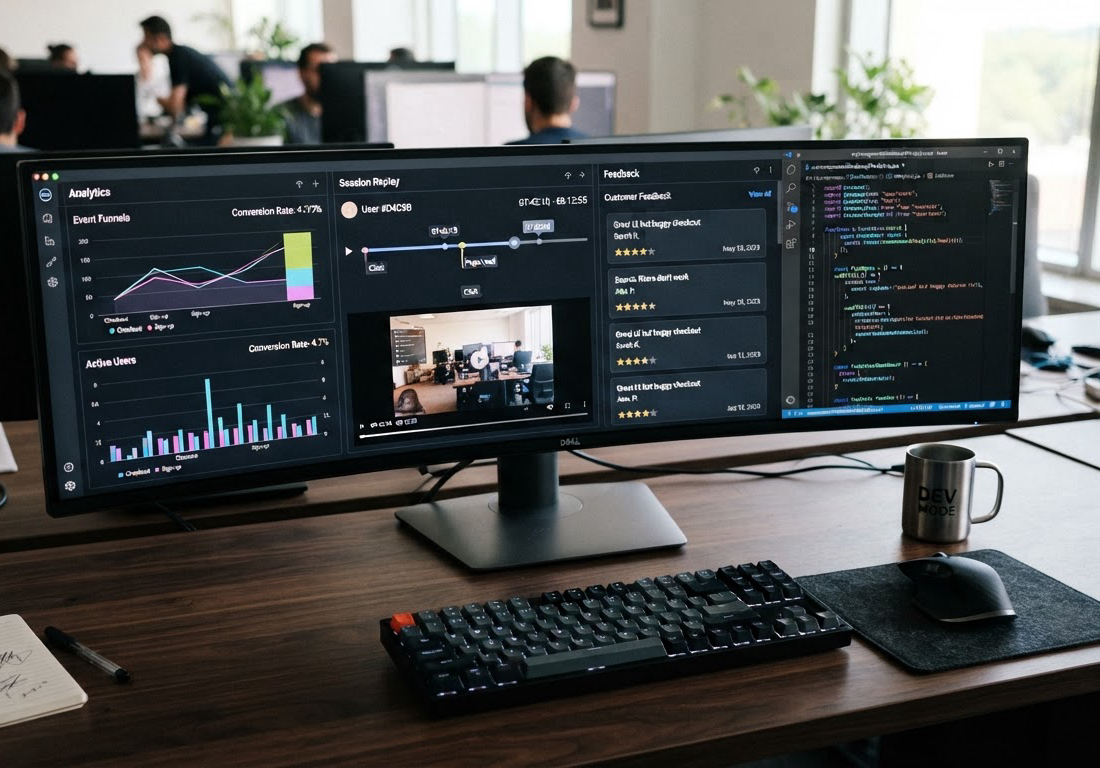
Esse cruzamento alimenta uma etapa intermediária obrigatória antes de qualquer alteração no repositório. Quando identifica uma falha de usabilidade ou oportunidade de conversão, o sistema redige uma proposta de correção acompanhada de um plano técnico e de critérios de aceite (acceptance criteria, as condições funcionais e de negócio que o código precisa satisfazer para ser aprovado). Só quando esse pacote está estruturado a tarefa segue para agentes de codificação (coding agents, ferramentas autônomas que leem repositórios, escrevem código e executam verificações), como o Codex da OpenAI ou o Wave Code Agent nativo da plataforma.
O contraste com o uso improdutivo de assistentes de programação aparece nessa fronteira de responsabilidade. Pedir diretamente a um agente de código que "melhore o engajamento da página inicial" sem lastro em telemetria costuma resultar em alterações arbitrárias de layout ou código quebrado. Ao separar o agente que investiga os dados do agente que edita os arquivos, o plano técnico funciona como um contrato verificável por humanos.
Evidências internas e o roteamento entre três modelos
Conectar leitura de código, análise de vídeo de sessões e raciocínio profundo em um fluxo contínuo cobra um preço alto de inferência se toda requisição acionar o modelo mais pesado disponível. A Amplitude afirma que o Wave tem na casa dos 80% de sua operação apoiada em modelos da OpenAI, divididos em três funções segundo o perfil de custo, modalidade e latência de cada etapa.
| Modelo utilizado | Função na arquitetura do Wave | Métricas internas reportadas pela Amplitude |
|---|---|---|
| GPT-6.1 Sol | Gerenciador de oportunidades (Opportunity Investigator) e investigações densas em código e ciência de dados (Data Science Agent) | Nota 4,06 de 5 na avaliação interna (contra 3,62, 3,52 e 2,94 de três alternativas); tempo mediano de investigação de 54 minutos; custo de US$ 1,34 por investigação; custo médio por acionamento 51% menor no Data Science Agent |
| GPT-6 Luna | Tarefas frequentes de alto volume e baixa latência, como varredura de código (code scanning) e pequenas checagens de avaliação | Mantém latência e custo reduzidos em execuções repetitivas (valores absolutos não divulgados pela empresa) |
| GPT-Image-2.5 Flare | Geração de protótipos visuais (mockups e wireframes, esboços estruturais de tela) | Utiliza capturas de tela das gravações de sessão reais como referência visual para desenhar a proposta |
Nas baterias de avaliação interna conduzidas pela Amplitude para o Opportunity Investigator, a vantagem do GPT-6.1 Sol sobre os três modelos alternativos testados concentrou-se em dois critérios técnicos: conformidade com contratos de ferramentas (tool-contract compliance, a precisão do modelo ao respeitar estritamente a estrutura de parâmetros exigida por chamadas de API e funções) e fundamentação em evidências (evidence grounding, a capacidade de ancorar diagnósticos nos registros fornecidos sem inventar premissas).
No caso real da página inicial da própria Amplitude, esse pipeline diagnosticou a baixa adesão aos cartões de sugestão e propôs sua personalização. Após uma revisão humana rápida sobre a recomendação, a equipe despachou o plano técnico para um agente de codificação e colocou a alteração em um teste A/B (experimento controlado que compara o comportamento de quem vê a versão nova contra um grupo de controle que vê a versão antiga). Em um dia, o volume de mensagens enviadas a partir dos cartões subiu 160% em relação ao grupo de controle. Segundo o relato da empresa, entre os experimentos, guias e feature flags (chaves de configuração que ativam recursos em produção sem exigir novo deploy) lançados por clientes usando o Wave, um em cada quatro entrou no ar no mesmo dia em que o agente apontou a oportunidade.
Revisão de arquitetura: como aplicar esse padrão no seu fluxo
Reproduzir esse ganho de velocidade em uma equipe de engenharia própria não exige reescrever toda a infraestrutura de dados de uma vez, mas requer abandonar o hábito de usar um único prompt monolítico para diagnosticar e programar. A revisão do fluxo do Wave mostra que a compressão do ciclo de um mês para até dois dias depende da qualidade do repasse (handoff) entre a leitura dos dados e a execução do código, somada à trava de revisão humana.
Padrão de arquitetura para conectar telemetria a agentes de código
- Isolar a varredura de alto volume em um modelo leve
Configure um modelo rápido e mais barato (papel que o GPT-6 Luna cumpre no Wave) para varrer rotas do repositório, filtrar logs de eventos e rodar validações curtas de saída antes de acionar raciocínio profundo.
- Exigir fundamentação estrita no agente investigador
Use um modelo com alta conformidade a esquemas de funções (como o GPT-6.1 Sol no relato da Amplitude) para cruzar métricas de queda de conversão com trechos específicos do código-fonte, proibindo sugestões que não citem eventos ou sessões reais.
- Gerar um contrato intermediário com critérios de aceite
Não permita que o agente de análise edite o repositório diretamente. A saída obrigatória da investigação deve ser um documento estruturado contendo: diagnóstico quantificado, arquivos afetados, plano técnico de implementação e critérios de aceite testáveis.
- Anexar referência visual quando houver mudança de interface
Se a alteração envolver front-end, utilize capturas da interface atual como entrada para um modelo de imagem gerar o esboço visual da modificação junto à especificação.
- Aplicar trava humana antes do despacho e validar com feature flag
Submeta o plano técnico a uma aprovação rápida da equipe antes de enviá-lo ao agente de codificação (como o Codex). Faça o deploy protegido por feature flag e meça o resultado contra um grupo de controle para retroalimentar o ciclo.
Equipes que separam a investigação analítica da escrita do código por meio de planos técnicos auditáveis reduzem o custo de inferência nas tarefas repetitivas e evitam que agentes autônomos empurrem alterações cegas para o repositório de produção.