Para as 372 famílias de resultados matemáticos que a OpenAI (abre em nova aba) divulgou na noite de 6 de outubro de 2026, quase tudo teria saído de um único comando entregue a um único agente de IA, ao custo médio de três horas de raciocínio no padrão do ChatGPT Pro. Foi o que um porta-voz da empresa afirmou à Scientific American. Um mês antes, o mesmo modelo interno, não liberado ao público, precisou de outra escala inteira de esforço para encarar as equações de Navier-Stokes: cerca de 10 mil agentes em esforço coletivo e milhões de dólares em poder computacional, segundo a mesma revista.
A distância entre os dois experimentos é o dado mais revelador para quem projeta sistemas agentivos. A fronteira científica que em setembro exigiu um enxame caro teria cedido, em outubro, a horas de processamento por resultado. Só que essa comparação descansa em alegações da própria empresa, sobre um modelo que ninguém de fora pode inspecionar. É aí que mora o nó do episódio.
O problema que vale US$ 1 milhão
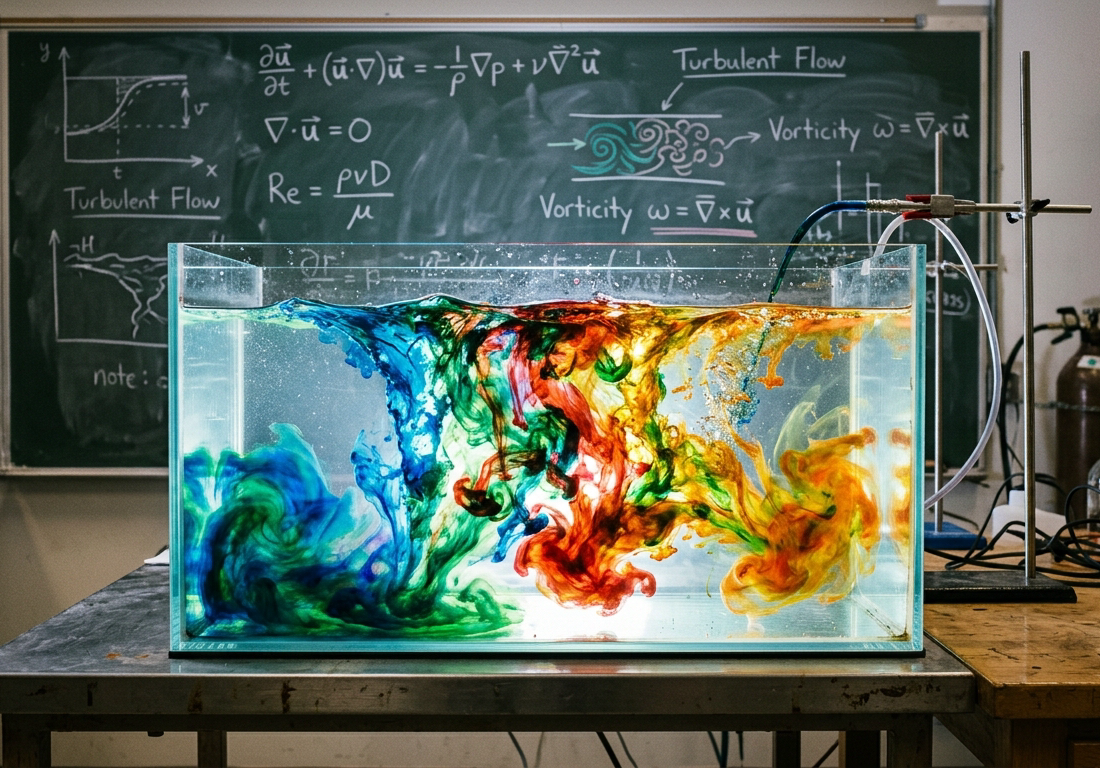
As equações de Navier-Stokes, formuladas no século XIX por Claude-Louis Navier e George Stokes, descrevem o movimento de fluidos: um sistema de equações diferenciais parciais que equaciona conservação de momento e massa, e do qual depende praticamente toda a dinâmica dos fluidos computacional, da aerodinâmica à meteorologia. O que quase dois séculos de análise não resolveram é uma pergunta aparentemente simples: dada uma condição inicial suave em três dimensões, a solução permanece suave para todo tempo, ou pode concentrar energia e curvatura até desenvolver uma singularidade em tempo finito, o chamado blowup, ponto em que velocidade ou suas derivadas deixam de ser bem definidas?
O Clay Mathematics Institute (abre em nova aba) colocou essa pergunta entre os sete Problemas do Milênio em 2000, cada um com recompensa de US$ 1 milhão. Da lista original, só a conjectura de Poincaré saiu, demonstrada por Grigori Perelman, que recusou o prêmio. O regulamento do Clay aceita as duas direções em Navier-Stokes: uma prova de suavidade global resolve o problema, mas um contraexemplo com singularidade também. O prêmio cobra, em ambos os casos, publicação em periódico com revisão por pares e aceitação duradoura pela comunidade.
Foi na direção negativa que a OpenAI entrou. Em 8 de setembro de 2026, a empresa anunciou que seu modelo interno teria demonstrado que escoamentos tridimensionais das equações podem desenvolver singularidades em tempo finito. Se o resultado se sustentar dentro do enunciado exato do prêmio, ele encerra a questão pela via do contraexemplo.
O que faz um enxame de 10 mil agentes
A OpenAI não abriu a arquitetura do experimento, nem os comandos usados, nem o nome do modelo. O padrão de funcionamento de sistemas desse tipo, porém, é conhecido de qualquer engenharia agentiva atual. Um agente é uma instância de modelo de linguagem com ferramentas, memória de trabalho e um loop operacional: propor uma jogada, executá-la, verificar o resultado, corrigir e repetir. Um enxame de 10 mil instâncias paraleliza justamente a parte mais cara da pesquisa matemática, que é a exploração de caminhos que morrem. Cada ramo da busca testa uma estratégia de demonstração; o que avança alimenta o passo seguinte, o resto é podado. Em essência, busca em árvore com verificaçãoo automática, só que os nós da árvore são redatores de provas.
A contagem de agentes chama atenção, mas o custo importa mais. Milhões de dólares em computação para um único problema significam que a OpenAI tratou a demonstração como problema de busca de escala industrial, não como exercício de chat. E significam também que o resultado tem valor econômico mensurável, ainda que o valor matemático esteja em disputa.
O matemático Andrew Sutherland, do MIT, resumiu a posição ao avaliar os anúncios posteriores da empresa: enquanto o modelo não for liberado e outros não puderem reproduzir os resultados, alegações de problema resolvido devem ser tratadas como não verificadas.
A contestação
Matemáticos contestaram o resultado desde o anúncio de setembro. A própria Scientific American publicou uma análise cujo título resume a dúvida central: a OpenAI teria resolvido o problema de Navier-Stokes errado, ou seja, uma variante que não corresponde exatamente ao enunciado do prêmio do Clay. A distinção não é pedantismo. Uma demonstração de singularidade em uma formulação modificada das equações, por mais sofisticada que seja, não transfere automaticamente o resultado ao problema premiado.
Há também a questão da autoria intelectual. Tristan Buckmaster, matemático da Universidade de Nova York que trabalhava justamente no problema atacado pela OpenAI, levantou um ponto incômodo: não está claro se pesquisadores que usam ferramentas de IA não acabam fornecendo, por meio da literatura que o modelo absorveu, as informações necessárias para que o sistema chegue à resposta final antes deles. "Provavelmente haverá vários casos em que eles pegarão o trabalho de alguém e o levarão até a conclusão", disse Buckmaster. Ele acrescentou que, com tantos resultados divulgados de uma vez, não houve tempo para análise aprofundada.
A pergunta que atravessa o debate é a que separa raciocínio criativo de recombinação: os modelos estão produzindo ideias novas ou apenas completando as etapas finais de demonstrações cuja concepção já estava em trabalhos humanos publicados? A OpenAI não respondeu de forma verificável. E a comunidade matemática discute se um ritmo acelerado de resolução, sem que a compreensão humana acompanhe, beneficia ou esvazia a disciplina.
Do enxame ao comando único
A divulgação de outubro, um mês depois, mudou os termos do custo. Segundo a OpenAI, o modelo recebeu cerca de 4 mil problemas em aberto e produziu 722 manuscritos organizados em 372 famílias de resultados, disponíveis com licença aberta no GitHub (abre em nova aba), cobrindo 17 áreas da matemática e da computação teórica.
| Dimensão | Navier-Stokes (set. 2026) | Lote de outubro (out. 2026) |
|---|---|---|
| Esforço | ~10 mil agentes em esforço coletivo | 1 agente e 1 comando por resultado, segundo a empresa |
| Custo | milhões de dólares em computação | ~3 horas de raciocínio ChatGPT Pro por resultado |
| Escopo | 1 Problema do Milênio | ~4 mil problemas tentados, 372 famílias |
| Modelo | interno, não liberado | interno, não liberado |
| Verificação | contestada por matemáticos | formalização em Lean (abre em nova aba) em 235 das 372 famílias |
Se a alegação do comando único for verdadeira, a Scientific American observou que um poder matemático sem precedente poderia se tornar acessível a qualquer pessoa. O condicional pesa. A OpenAI não divulgou custo total em dólares, nem o volume de tokens, nem o nome público do modelo, e um porta-voz disse que a empresa leva as diretrizes da comunidade a sério, mas não está obrigada a segui-las.
A verificação em Lean merece uma leitura técnica precisa. A linguagem formaliza cada passo de uma demonstração de modo que um programa confira a validade lógica da dedução. Isso garante que o argumento está correto a partir do enunciado escrito no código. Não garante que esse enunciado corresponde ao problema original, nem que as definições usadas são as usuais, nem que há algo de novo no resultado. Essa checagem final continua sendo trabalho humano, e é exatamente a etapa que a enxurrada de manuscritos tornou gargalo.
Regras novas para resultados de máquina
O episódio forçou a criação de um padrão de conduta inédito. Um conselho consultivo independente de matemáticos, sediado no Institute for Advanced Study em Princeton, publicou em 29 de setembro recomendações sobre como laboratórios de IA devem comunicar resultados matemáticos: divulgar o nome do modelo, os comandos usados, as cadeias de raciocínio e o custo computacional de cada resultado, e depositar o material em repositórios não controlados pelas empresas.
A OpenAI acatou parte. Publicou o repositório aberto, formalizações em Lean e resumos do raciocínio em dez resultados, além de instruções para conferência por terceiros. Manteve em sigilo prompts, custos e o nome do modelo. E rejeitou a recomendação mais dura do conselho, a de interromper testes de modelos proprietários em problemas abertos de fronteira. "Queremos deixar claro desde o início: não apoiamos essa prática", escreveu o grupo em seu comunicado.
Do lado da empresa, Dan Roberts, líder de pesquisa, defendeu os testes como necessários ao desenvolvimento de ferramentas melhores, com as demonstrações surgindo como subproduto. Do lado da academia, Melanie Wood, matemática de Harvard e integrante do conselho, resumiu a função do grupo: criar padrões e práticas para que os resultados divulgados por laboratórios de IA possam ser compreendidos pelos matemáticos e contribuir para o avanço da área. O contexto justifica a urgência: a OpenAI ampliou os testes para problemas inéditos porque, segundo a própria empresa, o modelo passou a acertar praticamente tudo nas avaliações de matemática que usava até então, incluindo desafios no nível da Olimpíada Internacional de Matemática. Quando o benchmark satura, o único teste restante é a fronteira sem resposta.
Para engenharia agentiva, o caso oferece três lições concretas. Primeira: verificação automática de lógica não elimina a revisão humana, apenas a reorganiza, concentrando o esforço na checagem de correspondência entre enunciado formal e problema real. Segunda: reprodutibilidade é o preço de entrada da credibilidade científica, e um modelo não liberado não passa desse preço. Terceira: a curva de custo entre setembro e outubro, se confirmada, indica que a capacidade de pesquisa profunda automatizada está caindo mais rápido do que a capacidade das instituições de auditar o que ela produz.
O regulamento do Clay mantém o prêmio condicionado à publicação com revisão por pares e à aceitação duradoura pela comunidade, com um período de espera de dois anos após a publicação. Nenhum manuscrito da OpenAI atravessou revisão independente até agora. Na contabilidade do conselho de Princeton, a divulgação dos resultados é "o início, e não a conclusão, do processo de compreensão humana e incorporação desse trabalho ao conhecimento matemático".