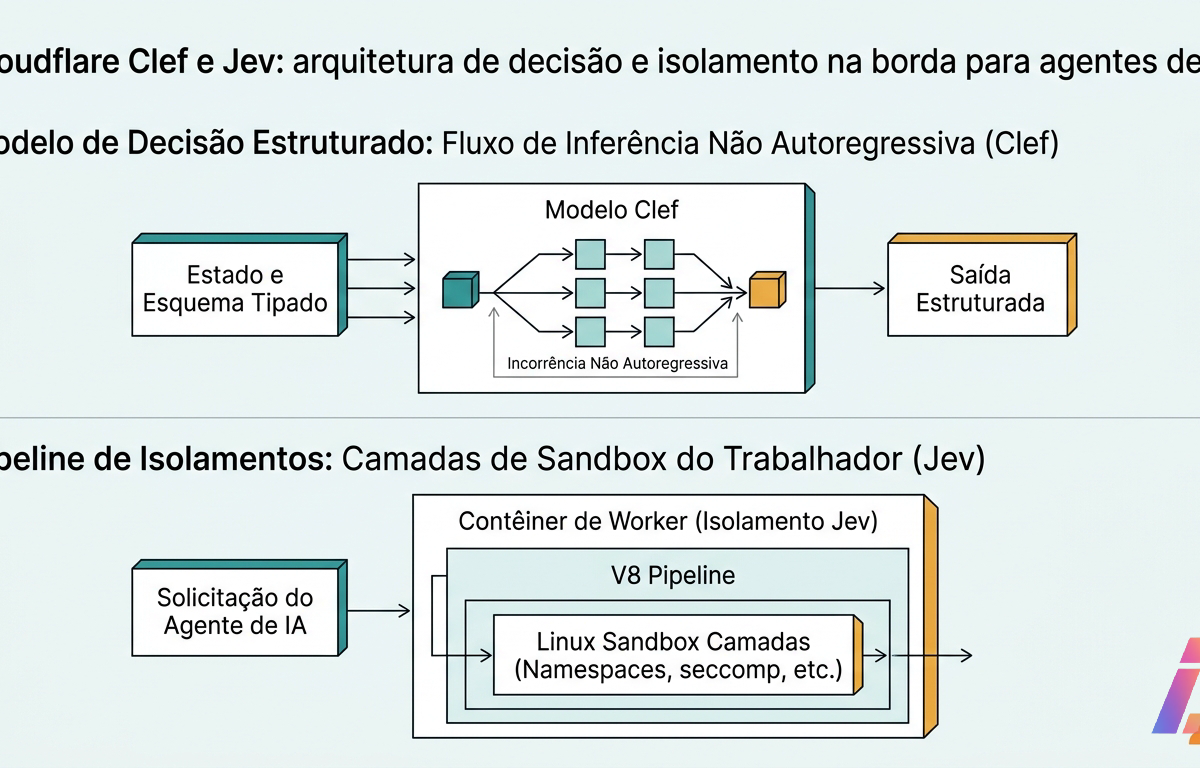
38,8. Essa quantidade de milissegundos registra o tempo mediano que o Clef-flash (abre em nova aba), modelo de avaliação estruturada desenvolvido pela equipe do Workers AI, leva para processar um estado de entrada e retornar distribuições de probabilidade fechadas para perguntas tipadas na borda.
O número ganha peso quando confrontado com a latência típica de modelos de linguagem de grande porte voltados a geração de texto, cujas respostas autoregressivas frequentemente ultrapassam centenas de milissegundos por token gerado. Sistemas agentivos que operam em pipelines de tomada de decisão costumam enfrentar um dilema persistente: a flexibilidade de modelos gerativos gerais impõe custos proibitivos de latência e superfícies complexas de validação sintática, ao passo que a execução de código arbitrário para resolver bifurcações lógicas exige sandboxes com isolamento rigoroso de memória. Na infraestrutura da Cloudflare, o ecossistema de inteligência artificial converge em duas abordagens distintas para resolver a orquestração de lógica: o uso de modelos de decisão estruturada — representados pelo Clef e pelo seu predecessor compatível, o Jev (abre em nova aba) da TypeSafe — e a execução isolada de código sintético gerado por modelos em ambientes de execução de borda via sandboxes baseadas em V8 Isolates.
A hipótese inicial em engenharia de sistemas agentivos sustentava que a geração de texto em formato estruturado (como JSON Schema forçado via gramáticas guiadas) resolveria de forma uniforme as necessidades de orquestração lógica na borda. No entanto, o custo computacional do decodificador autoregressivo token por token e a vulnerabilidade inerente a desvios de formato revelaram fissuras nessa premissa. O surgimento de modelos de decisão especializados e a evolução das defesas de runtime no Cloudflare Workers reconfiguram a divisão entre o que deve ser inferido probabilisticamente e o que precisa ser executado deterministicamente em memória isolada.
A taxonomia dos modelos de decisão: Clef e Jev no Workers AI
A sigla Clef não designa um acrônimo de comitê de avaliação acadêmica, mas o nome de batismo da primeira família de modelos de decisão em código aberto treinada pela Cloudflare, distribuída sob licença Apache 2.0 no Hugging Face em variantes de 27 bilhões de parâmetros (@cf/cloudflare/clef) e 9 bilhões de parâmetros (@cf/cloudflare/clef-flash). O Jev, por sua vez, refere-se ao modelo de avaliação estruturada desenvolvido originalmente pela TypeSafe e disponibilizado como serviço gerenciado no Cloudflare Workers AI sob o identificador typesafe/jev.
Diferente de modelos de fundação projetados para escrita conversacional, nem Clef nem Jev emitem sequências de texto livre. A arquitetura desses sistemas opera sobre um paradigma puramente avaliativo: o modelo recebe como entrada um estado documental arbitrário (como um payload JSON, registros de log ou texto cru) acompanhado de uma lista de perguntas estritamente tipadas. O modelo calcula, em etapa não autoregressiva, a probabilidade matemática correspondente a cada resposta válida permitida pelo esquema.
Ambos os sistemas suportam nativamente três tipos fundamentais de interrogação:
noul: uma interrogação binária de conformidade (sim/não), avaliando se determinada premissa se sustenta sobre o estado fornecido.choice: uma seleção entre múltiplas opções discretas predefinidas, calculando a distribuição calibrada entre os ramos possíveis.score: uma avaliação quantitativa com critérios delimitados, retornando valores numéricos normalizados e intervalos de confiança.
interface DecisionRequest {
  state: string | Record<string, unknown>;
  questions: Array<{
    id: string;
    type: "noul" | "choice" | "score";
    prompt: string;
    options?: string[];
    criteria?: string;
  }>;
}

interface DecisionResponse {
  answers: Array<{
    id: string;
    probability?: number;
    choice?: string;
    score?: number;
    confidence: number;
    probabilities?: Record<string, number>;
  }>;
}
O Clef foi projetado como substituto direto (drop-in compatible) para as chamadas de API direcionadas ao Jev. A cobrança informada pela Cloudflare para a hospedagem do Jev estabelece o valor de US$ 0,042 por 1 milhão de tokens de entrada, sem cobrança sobre tokens de saída em decorrência da ausência de geração textual tradicional. As chamadas não retêm dados na infraestrutura gerenciada, garantindo conformidade com padrões de retenção zero para clientes corporativos.
Mecanismos arquiteturais: atenção estruturada contra isolamento de runtime
A divergência estrutural entre a inferência de modelos de decisão e a execução de código sintético por agentes reside na forma como a semântica dos dados é processada e contida. Modelos como o Clef apoiam-se sobre uma espinha dorsal derivada da família Qwen, modificada por um treinamento pós-fundacional que introduz roteamento de atenção em dois estágios (two-stage attention routing) e atenção cruzada conjunta entre campos (joint cross-field attention).
Em vez de projetar matrizes de atenção sobre uma janela sequencial aberta, a pontuação limitada por esquema (schema-bound scoring) comprime a representação do estado diretamente contra as chaves das perguntas tipadas. A calibragem probabilística é obtida por meio de Aprendizado por Reforço para Decisões Calibradas (RLCD, Reinforcement Learning for Calibrated Decisions), metodologia que penaliza discrepâncias de confiança em cenários ambíguos. O Clef expande a janela de contexto para 64.000 tokens, contra o limite de 32.000 tokens do Jev da TypeSafe, integrando também um codificador de visão capaz de processar até quatro imagens simultâneas, capacidade inexistente no pipeline estritamente textual do Jev.
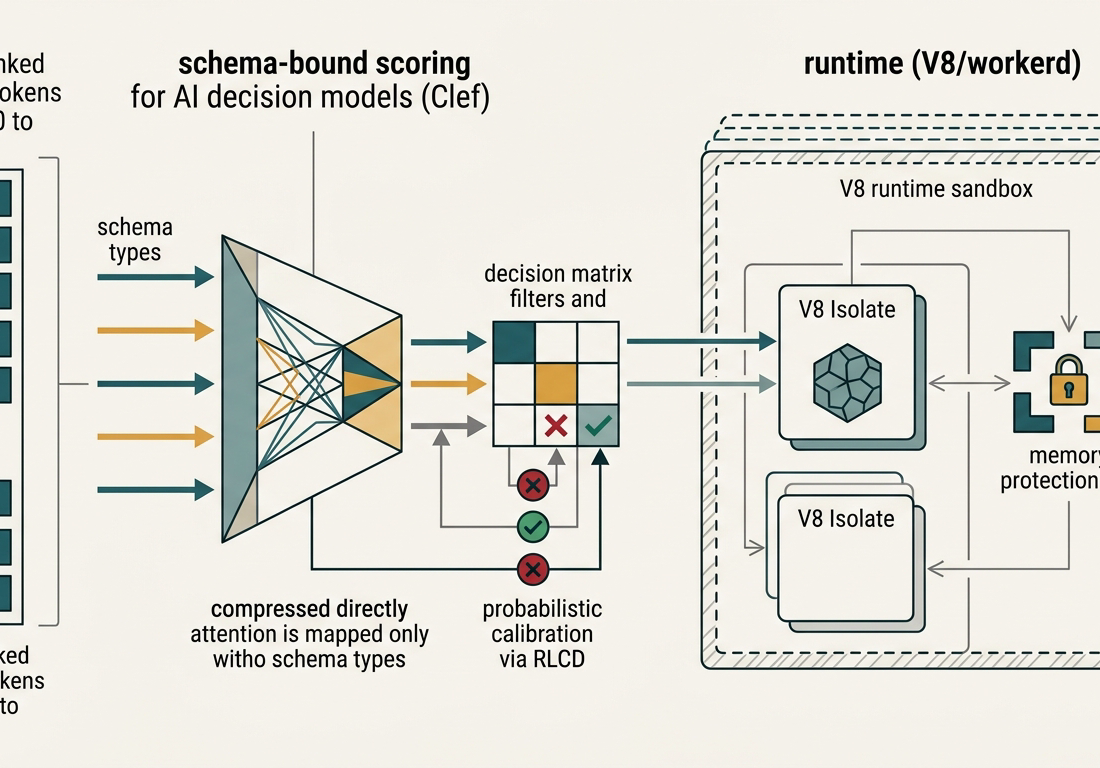
Quando um agente de IA necessita não apenas decidir um ramo condicional, mas sintetizar e rodar um script interpretado para consolidar dados, a borda da Cloudflare não recorre a modelos matemáticos, mas ao workerd, o runtime em C++ que sustenta o Cloudflare Workers.
A contenção desse código em tempo de execução opera sob a arquitetura de Isolates do motor V8 da Google. Em contraste com contêineres OCI clássicos, que encapsulam um sistema operacional completo com tempos de inicialização da ordem de centenas de milissegundos e pegadas de memória substanciais, os Isolates V8 instanciam contextos de execução separados dentro do mesmo espaço de processo em poucos milissegundos, consumindo poucos megabytes de memória. Conforme publicado pela Cloudflare na apresentação do Dynamic Worker Loader (abre em nova aba), essa mecânica permite subir sandboxes efêmeras cerca de 100 vezes mais rápido e com eficiência de memória entre 10 e 100 vezes superior à de contêineres virtuais.
A proteção do runtime contra vazamentos de canais laterais e ataques especulativos envolve restrições severas documentadas no modelo de segurança do Cloudflare Workers (abre em nova aba). O tempo monotonicamente crescente de Date.now() permanece congelado durante o ciclo de execução síncrona do Isolate para mitigar cronômetros de alta precisão que viabilizariam ataques do tipo Spectre. A concorrência por threads paralelas é banida no contexto do Isolate, e recursos de proteção de chaves de memória em hardware (MPK, Memory Protection Keys) são combinados a escaneamento estático de código antes da inicialização.
Em situações de alto risco ou execução de código gerado por modelos (como no recurso Code Mode), a Cloudflare insere uma segunda camada de sandbox (Layer 2 sandbox). O processo hospedeiro é enclausurado logo após a subida por meio de namespaces do Linux e perfis restritivos de seccomp, operando sobre um sistema de arquivos vazio e sem acesso direto a sockets de rede. Qualquer tráfego de rede ou leitura de configuração é intermediado por um processo supervisor independente através de sockets UNIX locais, com chaves criptográficas distintas por Worker.
A superfície de ataque do agente: limites do Isolate e integridade do heap
A coexistência de múltiplos locatários (multi-tenancy) dentro do mesmo processo hospedeiro via Isolates V8 cria uma tensão estrutural que não se manifesta na inferência vetorial de modelos como o Clef. O modelo de decisão limita a interação do dado de entrada a tensores matemáticos estáticos; o runtime JavaScript, por sua vez, aloca objetos na memória dinâmica através de rotinas complexas em C++.
Essa fronteira de segurança sofreu questionamentos práticos documentados. Em agosto de 2026, uma análise publicada pela Check Point Research (abre em nova aba) identificou cinco falhas de corrupção de memória no workerd, a camada de integração que conecta o motor V8 aos serviços de borda do Cloudflare Workers e ao Code Mode. Duas dessas vulnerabilidades foram classificadas como críticas. Os pesquisadores demonstraram a viabilidade de um ataque de leitura fora dos limites (out-of-bounds read) na implementação interna da API URLPattern.
A vulnerabilidade permitia que um Worker malicioso contornasse o isolamento lógico do V8 Isolate e realizasse leituras diretas no heap compartilhado do processo Linux. Em um cenário prático de agente de IA executando código arbitrário para manipulação de URLs, o código era capaz de acessar segredos de outros locatários hospedados na mesma instância de processo. A Cloudflare mitiga esse risco estrutural mantendo sistemas automáticos de aplicação de patches de segurança no V8 que entram em produção poucas horas após o lançamento de correções pelos desenvolvedores originais, somados a mecanismos de cordões dinâmicos (dynamic cordoning), que segregam Workers em máquinas distintas conforme o nível de confiança e o plano contratual do usuário.
A inferência puramente orientada a esquemas (Clef/Jev) elimina o vetor de corrupção de memória JavaScript em tempo de execução porque o código fornecido pelo usuário nunca é compilado pelo motor V8 com compiladores Just-In-Time (JIT). O processamento ocorre exclusivamente dentro da matriz de pesos dos modelos executados nas GPUs da infraestrutura do Workers AI.
O especialista em segurança Jerry Gamblin avaliou o impacto prático dessa distinção ao submeter registros estruturados de vulnerabilidades diretamente ao modelo de decisão da Cloudflare:
Para a maioria dos dados de segurança, você não precisa de um modelo que escreve. Você precisa de um que escolhe. O Clef da @Cloudflare leu 27.489 CVEs recentes. Fora do kernel Linux, cerca de 1 em 24 nunca diz por que a falha importa. CNAs: querem essa checagem antes de publicar?
A substituição de etapas de análise de segurança baseadas em execução de scripts por chamadas diretas de decisão estruturada reduz drasticamente a necessidade de instanciar sandboxes dinâmicas de código.
Benchmarks de latência e precisão em produção
A viabilidade técnica de modelos de decisão na borda é governada pela sua capacidade de responder a requisições com latência substancialmente inferior à dos modelos de linguagem tradicionais, mantendo índices elevados de calibração lógica. Em baterias de testes documentadas pela equipe de engenharia da Cloudflare cobrindo 43 execuções de referência, a variante Clef-flash estabeleceu uma velocidade mediana 13 vezes superior à do Jev, enquanto o Clef de 27 bilhões de parâmetros superou o Jev por uma margem de 2,5 vezes.
| Métrica / Benchmark | Clef-flash (9B) | Clef (27B) | Jev (TypeSafe) |
|---|---|---|---|
| Latência Mediana | 38,8 ms | 209,3 ms | 524,1 ms |
| Latência Percentil 95 (p95) | 122,4 ms | 238,6 ms | 536,0 ms |
| Janela de Contexto | 64.000 tokens | 64.000 tokens | 32.000 tokens |
| Modalidades de Entrada | Texto + até 4 imagens | Texto + até 4 imagens | Apenas texto |
| BFCL (Case Exact) | 98,76% | 98,47% | 95,75% |
| BANKING77 (Macro-F1) | 90,93% | 94,20% | 79,74% |
| Licença de Uso | Apache 2.0 | Apache 2.0 | Proprietária gerenciada |
Nos testes de fluxo de trabalho formulados originalmente pela própria TypeSafe para avaliar a qualidade de classificação em ambientes corporativos, o Clef superou o Jev em três das quatro áreas medidas:
- Processamento de faturas (invoice processing): Clef atingiu 64,7 pontos frente a 61,8 do Jev.
- Atendimento ao cliente (customer service): Clef registrou 76,3 contra 76,0 do Jev.
- Incidentes de segurança (security incidents): Clef marcou 62,9 diante de 61,7 do Jev.
O modelo Jev reteve a liderança apenas no rastreamento de execução de agentes (agent trace evaluation), registrando 71,6 pontos frente aos 68,5 obtidos pelo Clef.
Em fluxos operacionais de inteligência contra ameaças que integram classificação de páginas e navegação automatizada na borda, a combinação do Clef com a API do Browser Run registrou a análise e classificação de um domínio potencialmente malicioso em 2,2 segundos. Sob o mesmo fluxo e carga de entrada, um pipeline baseado no modelo gerativo de pesos abertos gpt-oss-120b exigiu 4,7 segundos para emitir a resposta final, evidenciando o impacto da sobrecarga autoregressiva no caminho crítico do tráfego web.
A discrepância na tarefa BANKING77, onde o Clef de 27B alcança 94,20% de Macro-F1 comparado a 79,74% do Jev, sugere que o ajuste supervisionado por RLCD confere maior robustez na distinção de intenções textuais sobrepostas, sem sacrificar a calibragem das probabilidades retornadas.
Cenários práticos e implicações para a arquitetura de borda
A decisão entre empregar modelos de avaliação estruturada (Clef/Jev) ou executar lógica em sandboxes isoladas de código (Dynamic Workers/V8 Isolates) mapeia diretamente a taxonomia de tarefas do sistema agentivo.
A adoção de modelos como o Clef e o Jev mostra-se recomendável em fluxos de trabalho onde o conjunto de ações subsequentes é finito, mas a classificação do estado depende de raciocínio contextual complexo. Exemplos incluem:
- Roteamento dinâmico de tráfego de segurança com base em payloads brutos não estruturados, identificando assinaturas de ataque sem necessidade de expressões regulares frágeis.
- Triagem e validação de conformidade em pipelines de CI/CD para alertas de vulnerabilidade ou relatórios de CVE.
- Extração com pontuação de confiança em documentos visuais e financeiros, aproveitando o codificador multimodal integrado do Clef para confrontar imagens de faturas com esquemas JSON.
O recurso a sandboxes de execução isolada com V8 Isolates, por outro lado, permanece indispensável nos cenários em que o agente precisa calcular transformações de estado de forma determinística, como a execução de cálculos matemáticos pesados, transformações de dados em memória via código sintético ou parsing de arquivos proprietários que não se enquadram em inferências de probabilidade.
A hipótese que tratava a geração genérica de código e a inferência de LLMs amplos como soluções universais para sistemas autônomos na borda é refutada pelos gargalos práticos de latência e pelos riscos de corrupção de memória compartilhada demonstrados em runtimes de baixo nível. O confinamento de tarefas de controle a modelos de decisão estruturada com etapas de decodificação não autoregressivas reduz o tempo de resposta mediano para a casa dos dois dígitos de milissegundos e elimina vetores de exploração baseados no interpretador JavaScript. Onde o processamento determinístico exige a instanciação de código dinâmico, a aplicação concorrente de defesas de hardware com MPK, namespaces isolados de segundo nível e ausência de APIs de arquivo consolida o estado da arte de contenção no workerd.