Quando uma falha de pagamento em massa atinge uma plataforma de comércio eletrônico durante a madrugada, o sistema de triagem automatizada não precisa de um parágrafo dissertativo sobre teorias de redes para tomar uma atitude. O fluxo de execução exige respostas booleanas imediatas e atribuições categóricas confiáveis: saber se o incidente é urgente, qual equipe deve ser acionada via plantão e qual a severidade da ocorrência em uma escala finita. No desenvolvimento de software tradicional, ramificações condicionais dependem de operadores aritméticos ou booleanos exatos, como verificar se um saldo bancário é menor que zero. Todavia, quando o predicado de decisão reside em textos não estruturados, capturas de tela ou logs complexos, as estruturas condicionais comuns falham.
A prática comum na indústria tem sido submeter esse volume de contexto a um modelo de linguagem abrangente instruído a retornar dados em formatos serializados, como JSON. Essa abordagem acarreta sobrecarga computacional desnecessária: o motor consome ciclos gerando sintaxe caractere por caractere, corre riscos contínuos de alucinação sintática e impõe latências inviáveis para rotas de execução síncronas. Os chamados modelos de decisão surgem justamente para eliminar essa camada de texto livre. Ao receberem um estado arbitrário e um conjunto fixo de perguntas tipadas, retornam unicamente distribuições probabilísticas calibradas. Em outubro de 2026, a Cloudflare (abre em nova aba) lançou a família Clef, composta pelos modelos Clef e Clef-flash, posicionando-se como concorrente frontal do Jev, lançado semanas antes pela TypeSafe AI. Compreender os fundamentos operacionais, os custos de infraestrutura e as reais divergências estatísticas entre essas soluções é essencial antes de redesenhar pipelines de orquestração de agentes.
O paradigma dos modelos de decisão sem geração autorregressiva
Para avaliar adequadamente o Clef, é indispensável compreender o mecanismo que o distingue dos modelos de linguagem convencionais. Em um modelo autorregressivo clássico, a resposta é sintetizada token a token por meio de sucessivas passagens para frente (forward passes). Cada novo elemento gerado é retroalimentado na camada de entrada, o que torna o processo dependente da extensão da resposta. Em tarefas de classificação ou roteamento lógico de agentes, grande parte dos recursos computacionais é consumida gerando chaves de dicionário, colchetes e palavras de preenchimento gramatical.
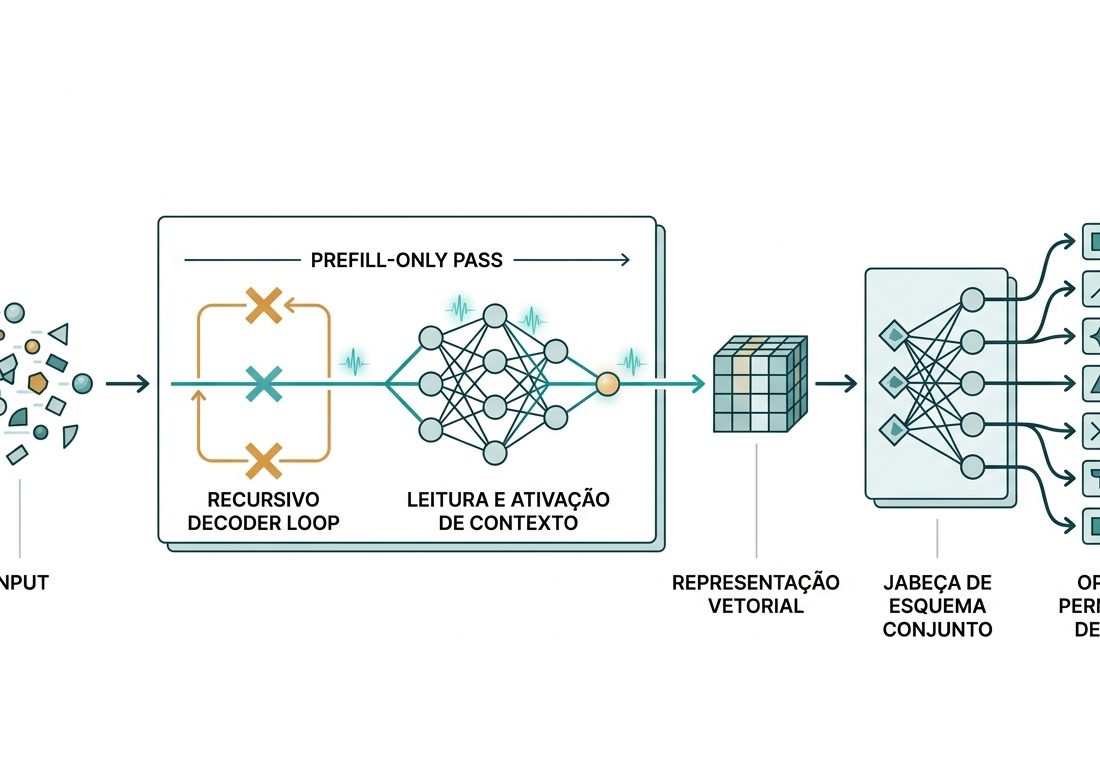
Os modelos de decisão eliminam inteiramente essa fase recursiva. Em vez de utilizar um decodificador para construir frases, o sistema processa a entrada uma única vez em uma passagem restrita de leitura e ativação de contexto (prefill-only pass). A representação vetorial resultante alimenta uma camada neural adicional projetada para avaliação simultânea: a cabeça de esquema conjunto (joint schema head). Essa estrutura mapeia as ativações internas diretamente para as opções permitidas de cada pergunta informada na requisição.
                                      +------------------------+
                                      | Entrada (Estado/JSON)  |
                                      +-----------+------------+
                                                  |
                                                  v
                                      +------------------------+
                                      |   Passagem Prefill     |
                                      | (Backbone Congelado)   |
                                      +-----------+------------+
                                                  |
                                                  v
                                      +------------------------+
                                      | Camada de Esquema      |
                                      | Conjunto (Paralela)    |
                                      +-----------+------------+
                                                  |
                     +----------------------------+----------------------------+
                     |                                                         |
                     v                                                         v
          [ Pergunta 1: noul ]                                      [ Pergunta 2: choice ]
          Probabilidade: 0.94                                       A: 0.02 | B: 0.88 | C: 0.10
Após o cálculo das pontuações brutas para todas as opções válidas, aplica-se a função softmax para normalizar os valores em distribuições probabilísticas que somam exatamente 1,0 por questão. Essa dinâmica confere propriedades operacionais importantes para pipelines de engenharia de software:
- Determinismo sintático absoluto: O modelo é estruturalmente incapaz de responder com termos fora do vocabulário estipulado pelo desenvolvedor. Não ocorrem quebras de chaves ou divergências de tipo primitivo.
- Custo nulo de geração: Como nenhuma palavra adicional é escrita, a contagem de tokens de saída é faturada e registrada como zero.
- Execução paralela de esquemas: Múltiplas perguntas associadas ao mesmo bloco informativo são calculadas simultaneamente, sem a degradação de tempo típica de saídas textuais extensas.
O sistema trabalha com três tipos de perguntas nativas, seguindo o padrão de nomenclatura estabelecido pelo Jev. O tipo noul representa uma verificação binária de verdade, retornando a probabilidade de uma premissa ser verdadeira. O tipo choice exige a seleção de uma entre 2 a 255 opções nomeadas e arbitrárias, acompanhada das respectivas probabilidades individuais e de uma métrica de confiança agregada. Já o tipo score posiciona o contexto em uma escala ordinal composta de 2 a 10 níveis descritivos dispostos em ordem crescente, retornando uma pontuação ponderada pelas probabilidades, a qual pode se situar entre dois patamares da escala. Uma única chamada aceita até 64 perguntas simultâneas avaliando um mesmo bloco de estado unificado.
A engenharia interna do Clef e Clef-flash
A Cloudflare estruturou sua família de decisão em dois patamares de capacidade distintos, ambos construídos sobre modelos abertos da linha Qwen, desenvolvidos pelo Alibaba Group. O modelo principal, batizado apenas como Clef, adota como base o Qwen3.8-27B, contando com 27 bilhões de parâmetros voltados a tarefas de raciocínio categórico que exigem alta precisão. A variante de alta frequência, denominada Clef-flash, emprega o Qwen3.5-9B, com 9 bilhões de parâmetros, direcionada para caminhos críticos de execução nos quais cada milissegundo de bloqueio de requisição impacta o usuário final.
O processo de treinamento do Clef preservou os pesos originais do modelo de base congelados. A equipe de engenharia acoplou e treinou a cabeça de esquema conjunto paralelamente a adaptadores de baixa densidade (Low-Rank Adapters ou LoRA) de posto 256. Esses adaptadores foram submetidos a conjuntos de dados sintéticos estruturados em que ordens de campos, formulações textuais e esquemas lógicos eram sistematicamente embaralhados para evitar sobreajuste situacional.
A função de perda aplicada durante o treinamento integrou o escore de Brier (Brier score), métrica estatística voltada a mensurar a distância quadrática entre probabilidades estimadas e os resultados reais observados. Quanto menor o escore de Brier, melhor calibrado está o modelo, indicando que uma previsão atribuída com 80% de confiança deve se confirmar na prática com frequência estatística próxima a oito em cada dez repetições. Sobre essa base, a Cloudflare aplicou uma etapa de aprendizado por reforço para decisões calibradas (Reinforcement Learning for Calibrated Decisions ou RLCD), uma abordagem que concede crédito parcial em respostas do tipo score quando a probabilidade calculada aponta para um nível adjacente ao correto na legenda.
Ambas as variantes preservam integralmente os codificadores de visão das arquiteturas Qwen subjacentes. Esse aspecto técnico representa uma expansão notável em relação ao escopo puramente textual: o Clef consegue inferir probabilidades sobre dados visuais e contextuais combinados, suportando o envio de até 4 imagens por requisição diretamente no array de entrada.
A integração prática na camada de aplicação
A invocação dos modelos Clef pode ocorrer por meio da infraestrutura gerenciada do Workers AI (abre em nova aba) ou em clusters computacionais próprios. Para consumo via API REST na plataforma hospedada da Cloudflare, o processo exige apenas a posse do identificador de conta e um token de autenticação dotado das permissões de leitura e edição no serviço.
O exemplo abaixo demonstra uma chamada clássica utilizando curl contra a rota do Clef-flash, submetendo um contexto não estruturado de incidente e formulando três consultas tipadas concorrentes:
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clef-flash \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "state": {
      "incident_log": "Checkout API retornando status 500 para todos os clientes da regiao sa-east-1 ha 45 minutos.",
      "affected_volume": 14200
    },
    "questions": {
      "is_urgent": {
        "type": "noul",
        "question": "Este incidente exige atendimento imediato fora do horario comercial?"
      },
      "responsible_team": {
        "type": "choice",
        "question": "Qual time de engenharia deve assumir a triagem primária?",
        "options": ["infraestrutura", "pagamentos", "frontend", "banco_de_dados"]
      },
      "severity_level": {
        "type": "score",
        "question": "Qual a gravidade operacional desta falha?",
        "legend": [
          "degradacao_menor_sem_impacto_financeiro",
          "degradacao_parcial_com_contorno",
          "bloqueio_critico_de_faturamento"
        ]
      }
    }
  }'
O retorno fornecido pelo motor abandona qualquer formato textual discursivo, entregando um corpo estruturado com as probabilidades calculadas diretamente no mesmo padrão consumido pelo runtime do Jev:
{
  "result": {
    "answers": {
      "is_urgent": {
        "type": "noul",
        "noul": 0.984
      },
      "responsible_team": {
        "type": "choice",
        "choice": "pagamentos",
        "probabilities": {
          "infraestrutura": 0.081,
          "pagamentos": 0.893,
          "frontend": 0.004,
          "banco_de_dados": 0.022
        },
        "confidence": 0.893
      },
      "severity_level": {
        "type": "score",
        "score": 2.91,
        "legend": [
          "degradacao_menor_sem_impacto_financeiro",
          "degradacao_parcial_com_contorno",
          "bloqueio_critico_de_faturamento"
        ],
        "probabilities": [0.002, 0.084, 0.914],
        "confidence": 0.914
      }
    }
  },
  "success": true,
  "errors": [],
  "messages": []
}Comparativo técnico: Clef versus TypeSafe Jev
Para as equipes que já projetaram pipelines em torno do Jev, lançado em setembro de 2026 pela TypeSafe AI, o Clef atua operacionalmente como um substituto imediato (drop-in replacement). A paridade estende-se aos nomes de parâmetros, tipagens de perguntas e formatos de retorno JSON. Essa compatibilidade direta simplifica ensaios comparativos de desempenho e precisão. Contudo, as arquiteturas subjacentes e as políticas comerciais divergem de maneira considerável.
| Parâmetro Técnico | Cloudflare Clef | Cloudflare Clef-flash | TypeSafe Jev |
|---|---|---|---|
| Arquitetura Base | Qwen3.8-27B (LoRA r=256) | Qwen3.5-9B (LoRA r=256) | Proprietária (não revelada) |
| Parâmetros Totais | 27 bilhões | 9 bilhões | Não informado |
| Janela de Contexto | 65.536 tokens | 65.536 tokens | 64k global (32k estado máx.) |
| Entrada Multimodal | Sim (texto, imagens e vídeo) | Sim (texto, imagens e vídeo) | Não (exclusivo para texto) |
| Licença dos Pesos | Apache 2.0 (aberto) | Apache 2.0 (aberto) | Proprietário fechado |
| VRAM Mínima Local | 85 GB | 41 GB | Inviável (somente API) |
| Latência Mediana | 209,3 ms | 38,8 ms | 524,1 ms |
| Latência Percentil 95 (p95) | 238,6 ms | 122,4 ms | 536,0 ms |
| Preço de Entrada (1M tokens) | US$ 0,24 | US$ 0,09 | US$ 0,042 |
Os dados de latência apurados nos testes comparativos da própria Cloudflare no benchmark Jev Decision Index (versão 0.2.1) evidenciam um abismo temporal. Enquanto o Jev registrou mediana de 524,1 ms, o Clef concluiu as inferências em 209,3 ms, e o Clef-flash completou suas rodadas em expressivos 38,8 ms. A Cloudflare atribui esse ganho temporal à execução dos pesos em sua rede descentralizada de borda (edge computing), minimizando o trajeto geográfico do pacote TCP entre a aplicação e o acelerador gráfico.
Entretanto, as métricas de acurácia revelam um cenário em que a escolha técnica não é trivial. Segundo a divulgação de medições efetuadas pela Cloudflare sobre o Jev Decision Index, o Clef lidera testes pragmáticos de classificação com margem significativa: obteve 98,5% de precisão exata no benchmark BFCL contra 95,8% do Jev; atingiu macro-F1 de 94,2 no BANKING77 diante de 79,7 do concorrente; e registrou 97,4 no CLINC150+OOS contra 89,3. Em cenários reais de fluxo operacional, o Clef superou o rival em triagem de incidentes de segurança e processamento de faturas, enquanto o Clef-flash obteve desempenho superior em suporte ao cliente.
Por outro lado, o Jev manteve liderança em testes que demandam abstração profunda e encadeamento dedutivo complexo. O modelo da TypeSafe marcou 78,3% no GPQA Diamond contra 48,0% do Clef; obteve 82,7% no MMLU-Pro contra 65,9%; e bateu o modelo da Cloudflare nas tarefas de When2Call (81,0% versus 72,4%), recuperação de dados BRIGHT (47,5 versus 45,9 nDCG@10) e observabilidade de rastreamento de agentes (agent trace observability).
Custos, auto-hospedagem e requisitos de infraestrutura
As diferenças entre Clef e Jev tornam-se agudas quando os fatores financeiros e a soberania de dados entram na equação. O preço por milhão de tokens de entrada cobrado pela TypeSafe no Jev é de US$ 0,042. Em contrapartida, no Workers AI, o Clef-flash custa US$ 0,09 por milhão de tokens (aproximadamente 2,1 vezes o preço do Jev), enquanto o Clef integral atinge US$ 0,24 por milhão (cerca de 5,7 vezes o valor do Jev).
Para dimensionar o impacto desse diferencial, considere um ambiente de produção que processa 1.000.000 de decisões analíticas mensais, com cada carga de estado e esquema demandando 2.000 tokens de contexto. A fatura mensal de consumo puro de tokens representará:
- TypeSafe Jev: US$ 84,00 (2.000 milhões de tokens × US$ 0,042)
- Cloudflare Clef-flash: US$ 180,00 (2.000 milhões de tokens × US$ 0,09)
- Cloudflare Clef (27B): US$ 480,00 (2.000 milhões de tokens × US$ 0,24)
O prêmio financeiro cobrado pela Cloudflare só encontra justificativa técnica em cenários onde a redução de latência é determinante para o negócio, ou onde a inferência sobre artefatos visuais é obrigatória.
Todavia, o ecossistema do Clef introduz uma flexibilidade inexistente no Jev: a liberação pública dos pesos sob a licença Apache 2.0 no Hugging Face (abre em nova aba). Isso permite que organizações operando sob regulações estritas de sigilo bancário, saúde ou segurança executem a infraestrutura dentro de seus próprios limites computacionais.
Adicionalmente, embora os pesos tenham sido rotulados sob Apache 2.0, a Cloudflare confirmou que os conjuntos de dados exatos utilizados no pré-treinamento e ajuste fino não foram abertos ao público. O pacote disponibilizado contém os tensores fragmentados (safetensors), a implementação da cabeça de esquema em arquivos Python dedicados (joint_schema_model.py) e os pesos de adaptadores, permitindo auto-hospedagem e ajuste fino especializado via infraestrutura própria ou através do serviço corporativo de ajuste por reforço da própria Cloudflare.
Limitações, vieses de calibração e análise crítica
A adoção de modelos de decisão exige discernimento técnico para evitar simplificações conceituais. Em primeiro lugar, deve-se observar com ceticismo metodológico os benchmarks fornecidos pela Cloudflare: os índices comparativos do Jev Decision Index apresentados em seu material de lançamento são medições auto-relatadas (self-reported) pela própria fornecedora, sem validação independente por pares até o momento.
Outro desafio crítico reside na suposição ingênua de que probabilidades preditas por uma rede neural equivalem a certezas absolutas de negócio. Embora a inclusão da função de perda de Brier e das etapas de RLCD mitigue distorções, um índice preditivo de 0,95 obtido em logs simulados não assegura precisão correspondente diante de incidentes atípicos de segurança (out-of-distribution events).
A probabilidade retornada pelo modelo deve ser tratada como um sinal estatístico de incerteza, nunca como uma autorização irrestrita de execução. Falhas em sistemas de decisão automática acarretam custos assimétricos: classificar incorretamente uma consulta de suporte comum pode gerar mero atrito temporário, enquanto descartar erroneamente um alerta crítico de invasão ou acionar indevidamente o desligamento de clusters de bancos de dados impõe custos severos. Engenheiros de software devem estabelecer limiares de acionamento baseados no custo do erro da aplicação:
- Ações de baixo risco e reversíveis (ex.: catalogar logs ou pré-selecionar tags de interface) podem operar com limiares probabilísticos relaxados, como
0.70. - Decisões irreversíveis ou disruptivas (ex.: acionar equipes de prontidão noturna, aplicar regras de firewall em larga escala ou emitir estornos financeiros) devem exigir confiabilidade superior a
0.98, retendo casos limítrofes para validação e auditoria humana.
Importa notar que o Clef não foi projetado para substituir agentes autônomos ou motores de raciocínio encadeado. Ele não formula planos de ação em etapas, não gera código de refatoração e não dialoga com o usuário final. Sua utilidade estrita reside nos pontos de bifurcação lógica de um grafo computacional maior, desempenhando a função de um oráculo probabilístico veloz e estruturado.
Julgamento de engenharia e cenários de escolha
A decisão de arquitetura entre Cloudflare Clef, Clef-flash e TypeSafe Jev depende fundamentalmente de três variáveis estruturais do projeto: restrições de latência na requisição, modalidades de entrada exigidas e requisitos de custódia computacional dos dados.
O TypeSafe Jev permanece como a alternativa economicamente mais racional para fluxos assíncronos orientados exclusivamente a texto. Em pipelines de processamento de filas, ETL semântico em lote (batch processing) ou avaliações de histórico de chamadas em que uma latência mediana de 500 ms é tolerável, seu preço de US$ 0,042 por milhão de tokens viabiliza uma economia de escala substancial em relação aos modelos da Cloudflare. Além disso, quando o problema depende de raciocínio dedutivo complexo e formal, como tarefas do padrão GPQA ou inspeção profunda de rastreamento de ferramentas (tool calling), as medições indicam maior solidez no motor da TypeSafe.
A escolha pelo Cloudflare Clef-flash impõe-se de maneira categórica quando a decisão precisa ocorrer no caminho síncrono do tráfego (hot path). Se uma requisição HTTP de usuário final precisa ser ramificada antes da resposta, a latência mediana de 38,8 ms proporcionada pelo modelo menor do Workers AI justifica o custo de US$ 0,09 por milhão de tokens. Sistemas de triagem imediata de requisições de API, direcionamento de intenção em interfaces em tempo real e regras dinâmicas de filtragem de conteúdo encontram no Clef-flash o equilíbrio ótimo entre fidelidade lógica e tempo de resposta.
Por sua vez, o Cloudflare Clef integral (27B) posiciona-se como uma escolha técnica indispensável quando o problema de classificação transcende o texto puro. Aplicações que necessitam correlacionar relatórios de erro com capturas de tela, inspecionar recibos digitalizados, validar layouts ou processar dados visuais de câmeras de monitoramento encontram nele capacidades inexistentes no ecossistema atual do Jev. Além disso, para corporações com impedimentos legais de envio de dados a APIs de terceiros, a publicação aberta dos pesos sob licença Apache 2.0 torna o Clef a única alternativa viável para implantação soberana em datacenters próprios, desde que haja capacidade de hardware para alocar os 85 GB de VRAM necessários por instância operacional.