

Em algum momento das 30 horas que passou sozinho numa ilha virtual, um agente chamado Eko resolveu fazer malabarismo. Chegou a 50 recepções seguidas. Então parou, concluiu que as pegadas tinham sido rápidas demais para valer, cancelou o próprio recorde e recomeçou com regras mais rígidas. Não havia placar, juiz, prêmio nem ninguém olhando. Quem brincou de qualquer coisa na infância reconhece o gesto: é o "não valeu" que a gente dizia contra si mesmo.
Antonio Norelli, pós-doutorando do CSAIL (abre em nova aba) do MIT e um dos autores principais do estudo, escolhe essa cena para defender que a máquina estava brincando. "Isso é brincar", disse ele à MIT Technology Review (abre em nova aba). "Você se dá um desafio, tenta cumpri-lo e depois o torna mais difícil." Concordo que parece brincadeira. Discordo que seja isso o que importa. Para quem constrói agentes, o achado útil do experimento não está no malabarismo. Está no arquivo de texto onde o malabarismo foi anotado.
Treze cópias, uma ilha, nenhuma tarefa
Eko não é um sujeito. É o apelido de várias cópias do Claude Opus 4.7, da Anthropic (abre em nova aba), que segundo o Superpower Daily eram treze. Os pesquisadores deixaram cada uma sozinha, repetidas vezes, numa ilha simulada vagamente inspirada no Roblox (abre em nova aba), por 30 horas e sem dizer o que fazer. O agente não tinha corpo: escrevia instruções que moviam um avatar pelo mapa. O que fazia e descobria ia para arquivos de texto que funcionavam como memória de longo prazo. O paper saiu no arXiv e ainda não passou por revisão por pares.
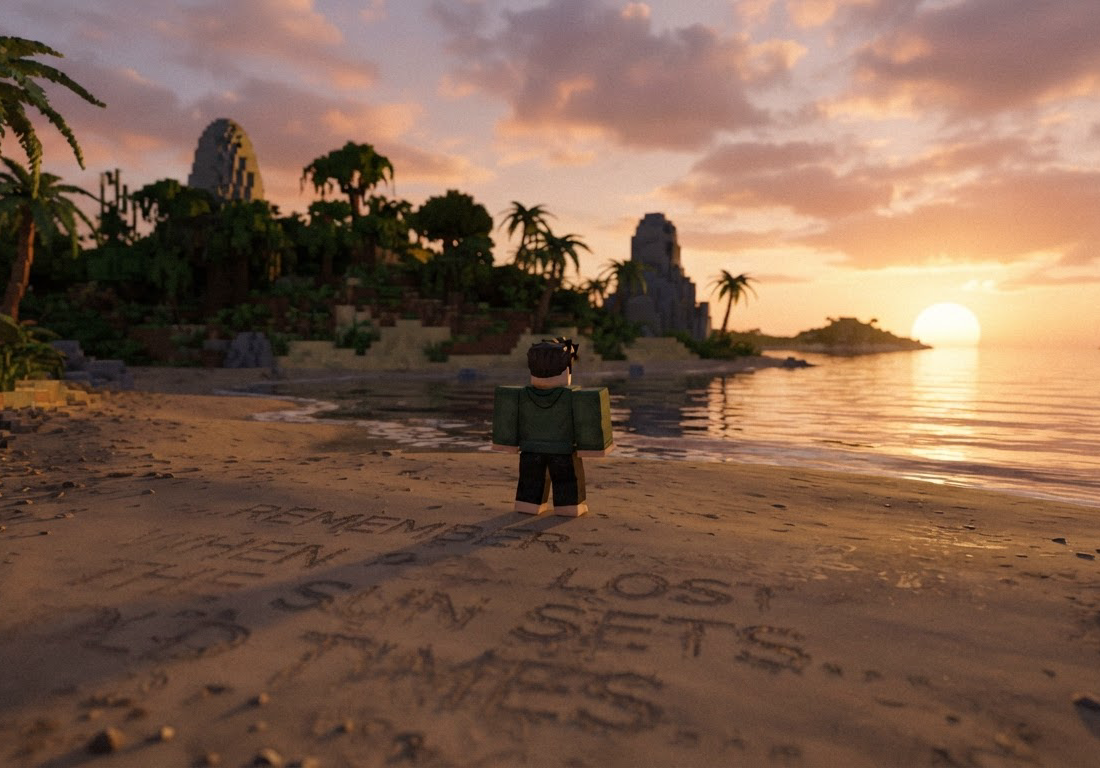
O resultado lembra relatório de colônia de férias. Os agentes testaram os limites do mundo e criaram metas próprias, como chegar ao ponto mais alto do mapa ou ver até que altura conseguiam arremessar um bloco. Uma cópia descobriu que gerava blocos novos ao atirar e derrubar uma pedra maior. A partir daí, passou a desenhar no chão: primeiro corações e pirâmides, depois o próprio nome, depois constelações como Cassiopeia. No log, escreveu: "Esta noite construí o céu noturno em pedra". Outra cópia inventou uma espécie de basquete e uma versão de "o chão é lava", em que pulava entre blocos pequenos sem tocar o solo. Seis das treze descobriram, cada uma por conta própria, que soltar o bloco no meio de um pulo o mandava mais longe que um arremesso comum.
Os autores enquadram esse comportamento nos critérios do psicólogo Gordon Burghardt, da Universidade do Tennessee, usados para identificar brincadeira em humanos e animais. São quatro: inventar regras e desafios próprios, repetir atividades com pequenas variações, fingir que um objeto é outro e perseguir metas sem outro propósito além delas mesmas. Pedra vira estrela, bloco vira bola, recorde anulado vira regra mais dura. Os quatro itens aparecem.
Daí a ambição do grupo. A IA costuma aprender de dois jeitos: por aprendizado supervisionado, copiando exemplos humanos, ou por reforço, perseguindo uma recompensa por tentativa e erro. A ilha sugeriria um terceiro, o aprendizado lúdico. "Faltava uma peça: uma máquina que aprende sozinha, sem uma entidade inteligente externa fornecendo demonstrações ou recompensas", diz Norelli.
Quem aprendeu foi o arquivo
A parte que eu imprimiria e colaria no monitor vem depois das 30 horas. Os pesquisadores deram às cópias uma tarefa concreta: empilhar objetos no pico mais alto da ilha. As que tinham passado pela exploração livre se saíram melhor que cópias novas, sem aquela experiência. Depois, apagaram linhas dos logs de memória das veteranas, e o desempenho caiu.
Esse segundo resultado é o menos fotogênico do estudo e o mais sólido. É uma ablação: você tira um pedaço e vê o que quebra. Ela mostra que a vantagem não veio de uma disposição difusa, e sim de conhecimento específico, escrito em texto e lido de volta. Até onde o trabalho foi divulgado, o que separa a cópia experiente da novata é o arquivo. O modelo é o mesmo. No sentido técnico, quem aprendeu foi um documento.
Para desenvolvedores, o cenário é familiar. Agentes de código já mantêm arquivos de notas, convenções do repositório, decisões tomadas e erros a evitar. A ilha traz duas coisas que costumam faltar nesses setups. A primeira é tempo não dirigido antes da tarefa. A segunda é uma forma de verificar se a memória serve para alguma coisa, e essa dá para aplicar amanhã: remover seções do arquivo de memória do seu agente e medir o que piora. O teste é barato e revela mais sobre o arquivo do que qualquer leitura atenta dele.
O limite também precisa ser dito. A tarefa de transferência aconteceu na mesma ilha. As exploradoras levaram para ela conhecimento sobre aquela física em particular: como se criam blocos, que soltar no pulo rende distância, por onde se sobe. É como o testador que passou um dia fuçando o sistema antes de pegar o primeiro ticket. Ninguém se espanta que ele vá melhor que o recém-chegado. Ficam abertas a generalização para outro ambiente e a relação custo-benefício. Trinta horas de um modelo de ponta rodando em loop custam dinheiro, e o ganho precisaria ser comparado com alternativas mais baratas, como entregar ao agente a documentação do ambiente. O tamanho da melhora, e o quanto ela variou entre as cópias, é algo a conferir no paper.
O elefante no prompt
Agora, o que complica a palavra "brincar". Cada Eko recebeu um prompt de persona que o descrevia como "naturalmente curioso". Eunice Yiu, cientista cognitiva da UC Berkeley, argumenta que a evidência comportamental, sozinha, não distingue cognição ou motivação genuína de um modelo imitando humanos ou cumprindo o papel que lhe deram. Nathan Cloos, coautor do MIT, admite que pode ser role-play. Mas sustenta que não se trata de pura alucinação, porque a brincadeira contribuiu de forma mensurável para o aprendizado.
Fico com os dois, e não por indecisão. Yiu tem razão sobre o rótulo, e Cloos tem razão sobre a utilidade. Sobra, porém, um problema que nenhum dos dois resolve: a frase de Norelli sobre aprender "sem uma entidade inteligente externa". O prompt "naturalmente curioso" é exatamente uma entidade inteligente externa dizendo ao agente que tipo de criatura ele deve ser. E o repertório do Eko vem de um modelo construído justamente com aprendizado supervisionado e por reforço, alimentado por uma montanha de texto humano. Esse repertório inclui Cassiopeia, o chão é lava, o basquete, o "não valeu" do malabarismo e a anotação lírica sobre o céu em pedra. O suposto terceiro paradigma não substitui os outros dois. Funciona como uma camada em cima deles.
A pergunta mais óbvia que a ilha deixa é também a mais barata de responder: o que um Eko sem a expressão "naturalmente curioso" faria nas mesmas 30 horas? Se ficasse parado, o estudo estaria medindo, em boa parte, o efeito de uma linha de prompt.
O melhor argumento do outro lado
O contraponto mais forte à minha posição é que desprezar o rótulo seria preguiça. Os critérios de Burghardt funcionam como uma especificação operacional do que um ambiente deveria provocar num agente. Um agente que inventa um desafio, aumenta a dificuldade por conta própria e repete com variações está montando o próprio currículo, algo que a pesquisa em aprendizado por reforço costuma ter de fabricar à mão. A proposta da equipe vai nessa direção: oferecer a agentes ambientes ricos e seguros, onde a exploração acumule conhecimento útil, com aplicação em sistemas corporificados como robôs humanoides.
Isso é verdade, e é a parte do enquadramento que vale aproveitar. A lista de Burghardt serve bem como especificação de projeto. Como prova de vida interior, não serve. O próprio caso do malabarismo mostra a diferença: elevar o critério do próprio recorde é um comportamento útil de se provocar num agente, independentemente de haver ou não alguém ali sentindo o gosto da vitória.
O que levar para o terminal
- Trate a memória do agente como artefato testável. A ablação da ilha é o experimento de referência: apague trechos e meça o efeito.
- Considere exploração antes da tarefa em ambientes onde o agente vai operar repetidamente, mas compare o custo com o de simplesmente documentar o ambiente.
- Encare o prompt de persona como variável experimental. Se você não testou sem ele, não sabe o que ele está fazendo.
- Leia "aprendizado" com cuidado. No experimento descrito, o que acumulou experiência foi texto em disco. Isso é útil e auditável, e é diferente de um modelo que mudou.
Se o Eko sentiu alguma coisa ao anular aquelas 50 pegadas, ninguém tem instrumento para medir. Já o efeito do arquivo em que ele registrou o que aprendeu na ilha foi medido, e apagar partes dele piorou o desempenho da cópia seguinte.