No dia 9 de outubro de 2026, a Anthropic acrescentou ao Claude Managed Agents (abre em nova aba) um recurso que muda a escala do que um único agente de IA consegue comandar: dynamic workflows, fluxos dinâmicos em que o próprio agente escreve um programa para coordenar centenas de outros agentes em segundo plano. O número que a empresa usa para vender a ideia é 1.000 agentes por execução. O número que usa para prová-la é 66 bugs encontrados em 70 plantados num código de 116 mil linhas.
Este texto examina os dois números em separado, porque exigem perguntas diferentes. O primeiro, o de 1.000 agentes, é uma questão de arquitetura: o que a documentação promete, com quais limites e o que acontece quando eles são atingidos. O segundo, o de 66 em 70, é uma questão de evidência: quem mediu, como, e o que o resultado não cobre. No fim, a pergunta que importa para quem escreve código e paga a fatura de tokens: sob quais condições essa arquitetura faz sentido e quando é só uma forma caríssima de terminar com 4 bugs a menos.
Como funciona um fluxo que um agente escreve para chefiar outros agentes
O nome oficial do bloco de configuração é multiagent_20261001, e a data no identificador não é casual: marca a versão do recurso. Quando um agente é definido com esse tipo na documentação de orquestração, ele ganha três capacidades combináveis: criar subagentes (agentes filhos aos quais delega tarefas pontuais), disparar dynamic workflows e consultar um advisor (um agente consultor que opina sem executar).
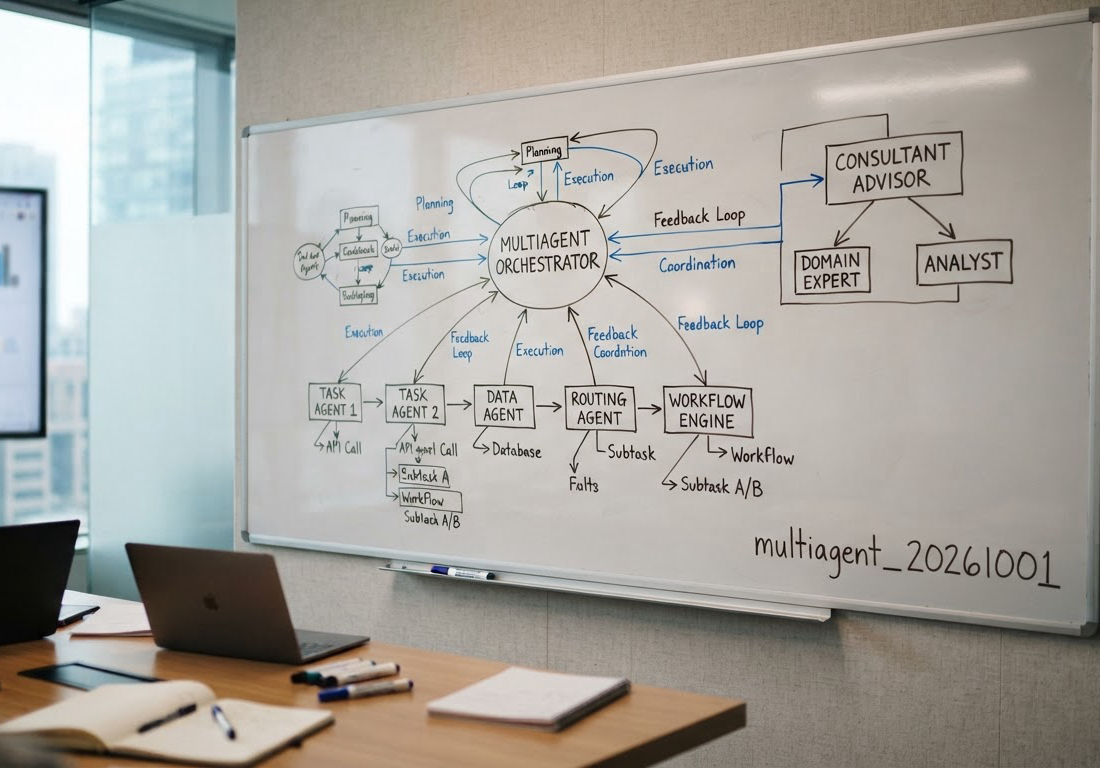
O mecanismo do workflow é o detalhe mais interessante do anúncio. Não é um humano desenhando um grafo de tarefas, como nos frameworks de orquestração tradicionais. É o agente líder que escreve um programa: um código que lança muitos agentes em fases, aguarda resultados e os combina. O servidor executa esse programa em segundo plano como uma run (execução), sem envolvimento direto do Claude que o originou. Ou seja, a inteligência da orquestração é gerada na hora, caso a caso, e depois roda sozinha.
Isso tem uma consequência que a documentação registra sem rodeios: depois que o programa está rodando, não há como mandar mensagens de acompanhamento às threads da run. Cada thread é arquivada ao fim da execução. Quem já debugou um job de CI que só aceita parâmetros antes de começar reconhece o modelo: você aposta no programa que o agente escreveu e torce para a premissa ter sido boa.
A hierarquia tem limites estruturais claros. A delegação tem um nível de profundidade; uma sessão sustenta no máximo 25 threads filhas simultâneas fora dos workflows; as listas de predefined_agents, tanto para subagentes quanto para workflows, aceitam até 20 agentes distintos. Um agente inline (criado na hora, sem definição própria) herda o modelo do agente da sessão. Para que partes da run usem outro modelo, é preciso defini-los como agentes previamente e listá-los em workflows.predefined_agents.
Os limites de escala, publicados na página de workflow runs (abre em nova aba), são o contraponto imediato ao título de "até 1.000 agentes":
| Limite | Valor documentado | O que acontece ao atingir |
|---|---|---|
| Threads trabalhando ao mesmo tempo em uma run | 64 | Nenhum novo agente é criado até um terminar; a API não garante o número, que pode mudar |
| Agentes iniciados por uma run durante toda a vida | 1.000 | A run termina com thread_limit_error |
| Vida útil de uma run | 24 horas por padrão | Termina com timeout_error; o tempo pausado continua contando |
| Runs abertas simultaneamente em uma sessão | 10 por padrão | Nova run é recusada com max_workflow_runs_error; runs ociosas contam |
A leitura honesta da tabela é: os 1.000 agentes são um teto acumulado sobre a vida inteira da run, não uma tropa de 1.000 soldados trabalhando lado a lado. O que trabalha em paralelo são até 64 threads, e nem isso é garantido contratualmente. Os 1.000 são a população total que o programa pode spawnar ao longo de até 24 horas, incluindo substituições. Há inclusive um detalhe revelador: se um agente falha, o servidor pode executá-lo de novo em outra thread, então uma run pode ultrapassar 1.000 threads no total. O limite de erro existe justamente porque a retentativa é comportamento esperado do sistema, não exceção rara.
O teste dos 70 bugs: o que o número mede e o que ele deixa fora
A prova de desempenho veio na mesma data, pela conta oficial @ClaudeDevs (abre em nova aba) da Anthropic no X. A metodologia, divulgada internamente e replicada pela cobertura de The Decoder (abre em nova aba) e por análise independente em Xenospectrum (abre em nova aba), foi: esconder 70 bugs numa base de 116 mil linhas e rodar três vezes cada abordagem.
Plantamos 70 bugs em uma base de código de 116 mil linhas. Em 3 execuções, um agente único encontrou 14, 15 e 27 bugs. Um workflow encontrou consistentemente 66 em cada uma das suas 3 execuções.
O gráfico resume os seis resultados, na única métrica divulgada:
| Indicador | Valor (bugs encontrados de 70 plantados) |
|---|---|
| Agente único, execução 1 | 14 |
| Agente único, execução 2 | 15 |
| Agente único, execução 3 | 27 |
| Workflow, execução 1 | 66 |
| Workflow, execução 2 | 66 |
| Workflow, execução 3 | 66 |
Fonte: Anthropic, teste interno divulgado em 9/10/2026
Antes de duvidar do 66, vale entender por que ele é plausível. Caçar bugs numa base grande é um problema que se decompõe bem: cada trecho do código pode ser varrido de forma independente, e a cobertura aumenta com o número de varredores. A variância do agente único, 14, 15 e 27, diz algo real sobre o problema: um único contexto de atenção percorrendo 116 mil linhas simplesmente não enxerga tudo, e o resultado depende muito de onde o olhar cai primeiro. Um fan-out (expansão em paralelo de muitos agentes sobre partições distintas) ataca exatamente esse gargalo. A consistência do workflow, 66 nas três execuções, também é dado, não só a média: repetibilidade é qualidade que um resultado isolado não mostra.
Dito isso, o que o teste não diz importa tanto quanto o que diz:
- Não há avaliação independente. O teste é interno, conduzido pela própria Anthropic, e até a data desta análise não há replicação de terceiros documentada nas fontes consultadas.
- Não há taxa de falsos positivos. "Encontrou 66 bugs" não diz quantos dos achados eram bugs de verdade nem quantos problemas reais fora dos 70 plantados foram detectados ou ignorados. Um varredor agressivo pode reportar muito e acertar pouco.
- Não se sabe o custo da resposta. Quantos tokens custou cada uma das três execuções do workflow, comparado a cada execução do agente único? O número não foi divulgado. Isso impede o cálculo mais relevante: bugs encontrados por dólar.
- Não se sabe a latência. Se o workflow levou 20 horas e o agente único levou 40 minutos, o trade-off muda completamente para quem tem um prazo.
- A tarefa é a mais favorável possível à arquitetura. Varredura exaustiva de código é o caso textbook de paralelização. Nada no teste indica como o workflow se sai em tarefas sequenciais, de design, ou que exigem contexto compartilhado. O próprio The Decoder registrou que se os ganhos se mantêm em outros tipos de tarefa "resta ver".
Um detalhe discreto reforça a leitura de tarefa favorável: o workflow errou os mesmos 4 bugs nas três execuções. Falhas sistemáticas e idênticas sugerem que há uma região do espaço de problemas que a estratégia de decomposição escolhida não alcança, não ruído aleatório. Para quem avalia a técnica, isso é mais informativo que o 66 em si.
Custo: a run não tem preço, e é exatamente aí que mora a questão
A documentação é clara num ponto que evita mal-entendido e abre outro: "uma run não tem preço próprio. Os tokens que seus agentes usam são cobrados como os demais tokens da sessão, nas tarifas de cada modelo". Ou seja, não existe preço de entrada no recurso; o que existe é consumo de tokens multiplicado por até mil agentes, cada um com seu contexto, suas ferramentas e seus erros. Os preços públicos da API da Anthropic são divulgados em dólares; as páginas de documentação consultadas não trazem precificação em reais nem condições específicas para clientes no Brasil, então o custo local exato depende da conta, da moeda de faturamento e das tarifas vigentes de cada modelo, que devem ser conferidas no painel da plataforma.
Para conter o estrago, a documentação recomenda definir um session budget (orçamento por sessão) que limita o gasto total, runs incluídas. E o próprio anúncio, segundo o The Decoder, avisa que esses workflows podem "queimar muitos tokens" e sugere começar pequeno. Quando o fabricante precisa advertir o cliente sobre a conta na mesma frase em que anuncia o produto, o sinal é legível.
O contraponto mais direto veio do lado concorrente. Um engenheiro sênior da OpenAI classificou recentemente enxames de agentes como um desperdício massivo de tokens, segundo o The Decoder. Não é uma declaração neutra, vem de quem vende soluções alternativas para os mesmos problemas, e por isso vale tratá-la como posição de mercado, não como medição. Mas ela aponta para uma ambiguidade que o teste da Anthropic não resolve: duas explicações competem pelo resultado de 66 em 70. A primeira é que a decomposição em muitos agentes melhora genuinamente a qualidade da varredura. A segunda é que mais agentes significam simplesmente mais computação jogada ao problema, e qualquer técnica que multiplicasse o orçamento de tokens por uma ordem de grandeza encontraria mais bugs. O teste compara um agente único com um enxame, mas não compara o enxame com um agente único que gaste o mesmo total de tokens. As duas hipóteses continuam plausíveis, e distinguir entre elas é exatamente o que uma avaliação independente deveria fazer.
O custo total documentado, portanto, vai além do token: há o custo de reexecuções automáticas (que podem ultrapassar as 1.000 threads), o tempo de wall clock dentro do teto de 24 horas (com tempo pausado contando), e o custo de engenharia de montar avaliação própria, porque o benchmark disponível não é seu código, seus bugs nem sua tarefa.
O que existe fora do teste da Anthropic
Quem já trabalha com orquestração multiagente tem alternativas consolidadas: o Agents SDK da OpenAI não, evidentemente, mas o OpenAI Agents SDK, frameworks como CrewAI, e a opção mais barata de todas, um workflow determinístico escrito por humano com chamadas a um único modelo. A comparação honesta, porém, esbarra numa lacuna: nas fontes consultadas não há benchmark de terceiros que meça essas alternativas na mesma tarefa, com a mesma metodologia. Comparar o 66 em 70 da Anthropic com números de outros frameworks exige cuidado, porque cada avaliação usa tarefa, métrica e orçamento próprios. A conclusão sustentável hoje é arquitetural, não numérica.
E a diferença arquitetural é substancial. Nos frameworks tradicionais, o humano desenha a orquestração: o grafo de tarefas é estático, auditável antes de rodar e reproduzível entre execuções. Nos dynamic workflows, o agente escreve o programa a cada caso. Isso compra adaptabilidade (a estratégia de decomposição se ajusta ao problema) e paga com auditabilidade: revisar o programa gerado antes da execução é um problema novo, e o comportamento de um programa escrito por um LLM sob pressão de prazo é, no mínimo, uma variável a mais. Para times com obrigações de compliance ou processos reproduzíveis, essa troca é material.
Quem deve adotar agora, e sob quais condições
O perfil de caso de uso em que o recurso tem mais chance de compensar é reconhecível: tarefas massivamente paralelizáveis, com saída verificável por máquina e sem necessidade de continuidade conversacional. Varreduras de segurança e de bugs em bases grandes, migrações de código repetitivas em milhares de arquivos, auditorias de conformidade em documentação volumosa, classificações em lote. Nessas tarefas, a cobertura que a decomposição compra é o que falta ao agente único, e a verificação automática compensa a ausência de follow-up.
O recurso tende a não fazer sentido quando a tarefa é sequencial ou exige julgamento acumulado (design de arquitetura, refatorações com dependência entre decisões), quando a latência importa (64 threads simultâneas não significam resposta rápida, e a run pode viver 24 horas), ou quando o volume de trabalho é pequeno demais para justificar o overhead de coordenação. Código de mil linhas não precisa de mil agentes. E quem opera com orçamento apertado deve lembrar que o teto de 10 runs simultâneas por sessão existe, mas o orçamento, não: sem session budget, a única trava é a fatura.
A recomendação operacional, que coincide com a da própria Anthropic, é tratar a primeira semana como amostragem: escolher uma tarefa real, limitada e verificável, rodar o workflow com orçamento pequeno, registrar custo e precisão, e só então decidir pela adoção. Comprar o 66 em 70 sem medir o próprio 66 em 70 é aceitar o benchmark de marketing como se fosse o seu.
O que a documentação admite sobre confiabilidade
Vale encerrar a parte técnica com o que a própria especificação assume como esperado, porque a taxonomia de erros conta uma história: thread_limit_error ao cruzar 1.000 agentes, timeout_error ao estourar 24 horas (com pausa contando contra o prazo), max_workflow_runs_error ao abrir a 11ª run simultânea. Um sistema que nomeia esses três modos de falha é um sistema cujo projetista espera falha por limite, por tempo e por capacidade. A concorrência de 64 threads, aliás, vem com a ressalva explícita de que a API não garante o número.
Nenhuma dessas limitações invalida o recurso; documentá-las é sinal de maturidade. Mas juntas descrevem uma ferramenta de beta público, segundo a cobertura de 9 de outubro, que exige cercas antes de produção: orçamento, monitoramento das runs, plano de tratamento para runs que morrem no meio, e a consciência de que threads pausadas gastam prazo de vida. A hipótese de trabalho sensata é a de infraestrutura promissora com contornos de custo ainda em aberto, não a de solução resolvida.
Veredito: o que os dois números provam, e o que ainda não
O número de 1.000 agentes é real como teto de arquitetura, documentado e condicionado a 64 threads simultâneas, hierarquia rasa e prazos curtos. O número de 66 em 70 é real como resultado de um teste interno bem desenhado para a tarefa mais favorável à técnica, com consistência que impressiona e lacunas que impedem generalização: sem taxa de falsos positivos, sem custo por execução, sem latência, sem avaliação independente, sem outra tarefa à vista. Entre "a orquestração melhora a qualidade" e "mais computação compra mais cobertura", o teste publicado não decide. Para desenvolvedores, a decisão racional hoje é experimental e barata: vale configurar um agente do tipo multiagent_20261001, aplicar o recurso a uma varredura paralelizável e verificável do próprio domínio, com orçamento travado, e deixar que a medição própria responda o que o benchmark da Anthropic deixou em aberto. Quem fizer isso antes de apostar o pipeline inteiro em mil agentes estará exatamente onde a evidência atual permite estar.
Perguntas frequentes
Os 1.000 agentes rodam todos ao mesmo tempo?
Não. Os 1.000 são o total de agentes que uma run pode iniciar durante toda a vida dela. O trabalho simultâneo é limitado a 64 threads, número que a API nem garante, e ao atingir 1.000 agentes a run termina com thread_limit_error.
O resultado de 66 em 70 bugs foi avaliado por terceiros?
Não há registro de avaliação independente. O teste foi interno da Anthropic, divulgado em 9 de outubro de 2026 pela conta oficial de desenvolvedores, e a cobertura externa analisou os dados divulgados sem replicar o experimento.
Quanto custa uma execução com dynamic workflows?
Não há preço fixo da run: os tokens de todos os agentes são cobrados nas tarifas de cada modelo, como os demais tokens da sessão. A Anthropic não divulgou o custo das execuções do teste e recomenda definir um session budget e começar com escala pequena.
Como ativar o recurso?
Configure o agente com o tipo multiagent_20261001 no bloco multiagent da definição do agente na API da Anthropic; por padrão, subagentes e dynamic workflows já vêm habilitados nesse tipo, e agentes pré-definidos podem ser listados para a run usar outros modelos.