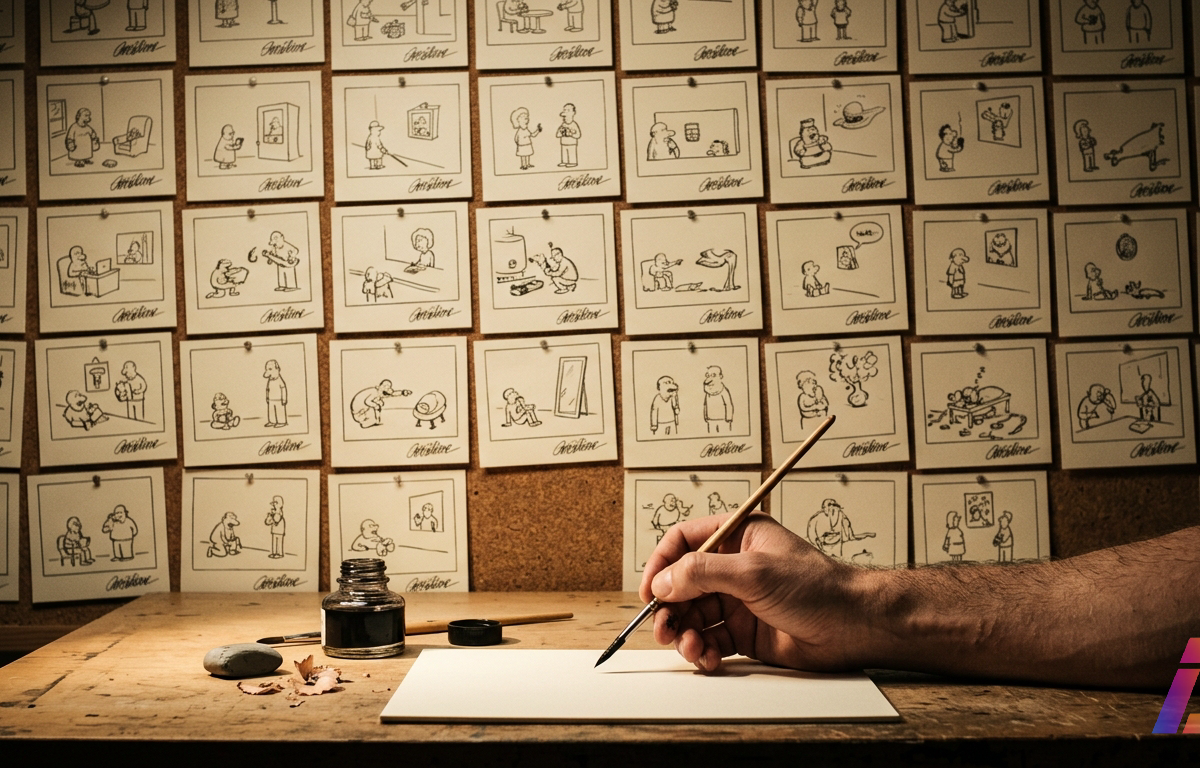
"Foi muito parecido com uma violação da minha pessoa." A frase é do cartunista Brendan Loper, falando ao Nieman Lab sobre um desenho que circulou em massa nas redes depois das mortes de Dolly Parton e Tim Curry, no fim de agosto de 2026. Na imagem, os dois entram de braço dado no paraíso, no traço característico da The New Yorker. No canto inferior direito, a assinatura "BLOPER", o pseudônimo que Loper usa em tudo o que publica.
Só que Loper não desenhou nada disso. E não assinou. O quadrinho saiu inteiro do ChatGPT (abre em nova aba), a pedido de uma fã de Dolly Parton que pediu ao modelo um "cartoon estilo New Yorker". Um único tweet com a imagem passou de 25 mil curtidas.
Não foi um caso isolado
A primeira impressão é a de um acidente pontual, um prompt azarado que calhou de pedir justamente o artista certo. A documentação do Nieman Lab corrige essa leitura. Foram identificadas assinaturas de mais de 15 cartunistas da revista reproduzidas pelo gerador de imagens da OpenAI, sem permissão e sem compensação: Harry Bliss, Emily Flake, Joe Dator, Pat Byrnes, Peter Vey, Jason Adam Katzenstein, George Booth, Liza Donnelly, Ellis Rosen e Saul Steinberg, entre outros. Em vários casos, o modelo nem precisava do nome do artista no prompt. Bastava pedir o estilo da revista para que a assinatura aparecesse junto.
Emily Flake descreveu o resultado ao Nieman Lab com uma precisão que serve de diagnóstico técnico: "Consigo ver o DNA do meu trabalho ali, mas ainda não parece algo que eu desenhei. É como ver um primo distante." A frase separa duas coisas que, em geração de imagens, costumam vir coladas: o estilo, que é um padrão estatístico difuso, e a assinatura, que é um identificador único e verificável.
Por que o modelo assina
A explicação começa na forma como modelos multimodais aprendem. O gerador de imagens por autorregressão que alimenta o ChatGPT não guarda "desenhos" como arquivos. Ele aprende distribuições de pixels condicionadas a texto, a partir de corpora massivos varridos da web. Nesses corpora, quadrinhos publicados pela The New Yorker (abre em nova aba) aparecem repetidamente com três elementos correlacionados: o traço da casa, o formato da legenda e a assinatura manuscrita do autor no canto. O modelo não distingue semanticamente esses elementos. Para ele, "cartoon estilo New Yorker" é uma região do espaço latente onde estilo, composição e assinatura coocorrem. Peça um, e a regressão devolve os três.
Aqui entra um fenômeno bem documentado em modelos generativos: memorização. Quando um padrão visual é repetido com pouca variação em muitos exemplos de treino, a fronteira entre generalizar o estilo e reproduzir o artefato se dissolve. Não é exatamente overfitting clássico, porque o modelo generaliza o estilo; é o que a literatura chama de contaminação por artefatos de treino, o mesmo mecanismo que já fez modelos abertos reproduzirem marcas d'água de bancos de imagens presentes no scraping. A assinatura é, do ponto de vista estatístico, um artefato de alta redundância e baixa entropia grudado a um cluster de estilo. É justamente o tipo de coisa que um modelo condicional aprende sem querer.
Há um detalhe que agrava o caso. Assinatura não é só pixel. É nome. É atribuição de autoria, o que transforma um problema de qualidade de dados em um problema de identidade: o output leva terceiros a acreditar que uma pessoa fez algo que ela não fez. No exemplo viral, a assinatura "BLOPER" foi o que fez milhares de pessoas tratarem a imagem como desenho humano.
A resposta da OpenAI
Uma porta-voz da OpenAI (abre em nova aba) declarou: "Acreditamos que o futuro da criatividade é fundamentalmente humano, e nosso foco é construir ferramentas que capacitem a criatividade e os criadores. Agradecemos muito à comunidade por sinalizar bugs e comportamentos não intencionais de nossos modelos, para que possamos corrigi-los."
Depois de notificada, a empresa passou a exibir um aviso de classificador no momento do prompt:
Este prompt pode violar nossas barreiras de segurança relacionadas à similaridade com conteúdo de terceiros.
Chame a atenção para a palavra "pode". O aviso é condicional e, segundo o Nieman Lab constatou até a publicação, o modelo continuou assinando alguns quadrinhos com nomes reais mesmo depois de acionado. O Mashable relatou o mesmo comportamento: imagens continuaram sendo geradas no estilo da revista, assinaturas incluídas.
| Camada de mitigação | O que faz | Limitação observada no caso |
|---|---|---|
| Aviso de guardrails no prompt | Classifica a intenção e alerta o usuário | Texto condicional; não bloqueia a geração |
| Filtro de saída | Deveria barrar reprodução de conteúdo protegido | Assinaturas seguiram aparecendo após a notificação |
| Curadoria de dados de treino | Evitaria a memorização na origem | New Yorker afirma nunca ter autorizado treino sobre seus quadrinhos |
O quadro jurídico
Os fatos documentados desenham um cenário desconfortável para a OpenAI. Em 2024, a Condé Nast fechou um acordo de licenciamento multi-anual com a empresa cobrindo boa parte de seu conteúdo, com termos não públicos. Mas uma porta-voz da The New Yorker afirmou ao Nieman Lab que a empresa nunca concedeu a nenhum desenvolvedor de LLM permissão para treinar modelos sobre seus quadrinhos, e que os contratos padrão de freelancers da revista não permitem licenciar o material para treino de IA.
Se as assinaturas foram memorizadas, é razoável inferir que os quadrinhos estiveram, de alguma forma, nos dados de treino. Essa é uma inferência, e deve ser lida como tal: a OpenAI não confirmou a origem dos dados que produziram o comportamento. A inferência, porém, é difícil de escapar. Um modelo não aprende a caligrafia de Pat Byrnes por coincidência.
Para desenvolvedores, vale mapear as categorias jurídicas em jogo, porque elas têm exigências diferentes:
- Direito autoral sobre a obra: protege o desenho em si; a questão central é se houve cópia substancial derivada de treino não autorizado.
- Direitos morais e de atribuição: protegem o vínculo entre autor e obra; a assinatura falsa atinge diretamente essa esfera, independentemente de o traço ser "apenas parecido".
- Marcas e identidade da publicação: o "estilo New Yorker" enquanto ativo editorial, tema que o acordo de licenciamento de 2024 deixou em zona cinzenta.
A alegação de Loper sobre "violação da pessoa" aponta justamente para a segunda categoria, a mais difícil de mitigar com filtros. Um estilo pode ser legalmente contestável; um nome caligráfico atribuído a uma pessoa real é um fato verificável e falso, e é bem mais difícil de defender.
O que muda na prática
O caso chega num momento em que a indústria discute proveniência de conteúdo sintético, com padrões como o C2PA ganhando tração como forma de marcar origem de mídia. O episódio mostra o outro lado dessa moeda: não basta certificar que uma imagem foi gerada por IA. É preciso garantir que a imagem não carregue, dentro de si, a identidade de alguém que não a fez.
Para o time técnico, três lições sustentadas pelo que foi documentado:
- Mitigação pós-treino é frágil por construção. Um classificador de prompt adicionado depois de um relatório de imprensa corrige o sintoma, não a memorização. A assinatura continua no espaço de pesos do modelo.
- Artefatos correlacionados de treino vazam juntos. Estilo, legenda e assinatura foram aprendidos como um único padrão condicional. Filtrar um componente sem tocar nos outros é um problema aberto de pesquisa, não um ticket de bug.
- Atribuição falsa é um risco de produto. O dano não é estético. É reputacional e jurídico, e se materializa no instante em que um humano acredita na autoria.
A OpenAI disse apreciar a comunidade que sinaliza "comportamentos não intencionais". A frase é diplomaticamente correta e tecnicamente honesta. O modelo não decidiu forjar nada; ele fez exatamente o que a distribuição de treino mandou fazer. Mas isso não conforta muito um cartunista que viu sua caligrafia, a marca da sua pessoa, estampada em um desenho que ele jamais faria. Uma violação da pessoa, como disse Loper, é isso: a assinatura estava certa. O resto, tudo mais, é que não era dele.