
O download é livre, não pede cadastro e a licença autoriza quase tudo, inclusive destilar, quantizar, ajustar e revender. Só tem um detalhe pouco convidativo: na precisão original, os pesos do Beam 1.0 ocupam perto de 934 GiB. São grátis no mesmo sentido em que um terreno doado é grátis. A escritura sai de graça, a obra não.
Essa é a tensão que define o primeiro modelo de pesos abertos da Reflection AI. A licença Apache 2.0 é das mais permissivas do mercado, mas um modelo de 501 bilhões de parâmetros traz uma conta de infraestrutura que, para a maioria das equipes, empurra o uso de volta para a API. E a API, por enquanto, tem preço definido por terceiros, não pela própria Reflection. No meio disso, os benchmarks impressionantes vêm todos da mesma origem: a empresa que treinou o modelo.
O que foi publicado em 16 de outubro
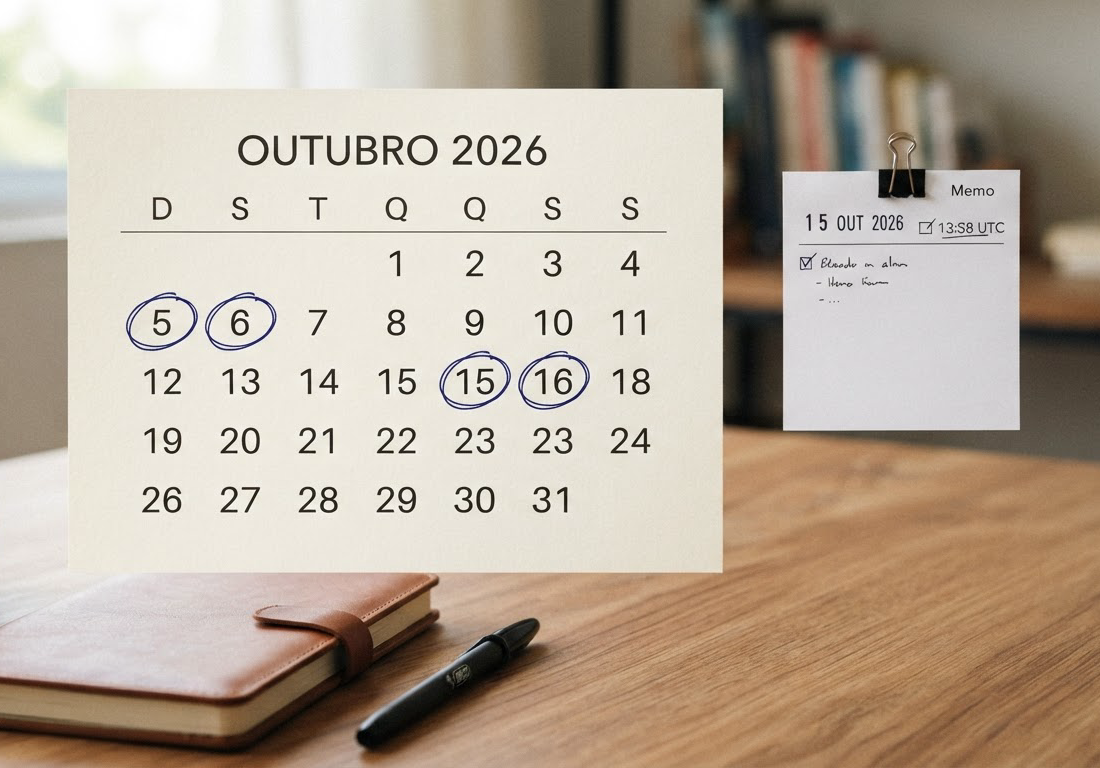
A sequência importa porque houve um intervalo entre promessa e entrega. Em 5 de outubro de 2026, a Reflection anunciou o Beam em prévia seletiva e prometeu os pesos sob Apache 2.0 "ainda este mês". Uma checagem publicada pelo site Ontic Post registrou que, em 15 de outubro às 13h58 UTC, a organização reflection no Hugging Face listava zero modelos. No dia seguinte, o anúncio oficial do lançamento (abre em nova aba) declarou os pesos disponíveis.
As duas informações não se contradizem. O site S5 Labs, que acompanhou o caso, encontrou o repositório BF16 criado em 7 de outubro e as versões FP8 e NVFP4 em 10 de outubro, públicos e sem gating (a exigência de aceitar termos ou pedir acesso antes de baixar). Os arquivos existiam antes, privados, e foram abertos perto do anúncio. O próprio S5 Labs admite não ter conseguido cravar o dia exato da abertura.
Segundo a compilação do AI Wiki, que cita os cards do Hugging Face, a coleção "Beam 1.0" tem quatro repositórios:
| Repositório | Conteúdo | Tamanho declarado |
|---|---|---|
Beam-1.0-501B-A23B | Modelo instruído, BF16 | 933,81 GiB |
Beam-1.0-501B-A23B-FP8 | Quantizado com LLM Compressor | 468,72 GiB |
Beam-1.0-501B-A23B-NVFP4 | Quantizado com NVIDIA Model Optimizer | 273 GiB |
Beam-1.0-501B-A23B-DFlash2 | Drafter para decodificação especulativa, 1,93 bilhão de parâmetros | não informado |
Junto com os pesos vieram tokenizador, implementação de referência, um relatório técnico de segurança e o Mirror CLI, ferramenta de agente sobre a qual se fala mais adiante. O que não veio: o relatório técnico do modelo, marcado como "em breve" na página do repositório no Hugging Face (abre em nova aba), e as receitas de autodestilação, prometidas pela Reflection "nos próximos dias". Sem esse relatório, a arquitetura é conhecida pela tabela do card, e o treinamento, só por descrições parciais.
A licença é o ponto menos ambíguo. O repositório inclui o arquivo LICENSE com o texto padrão da Apache 2.0, que permite uso comercial, modificação e redistribuição e inclui concessão de patentes dos contribuidores. O model card da Reflection (abre em nova aba) vai além do que a licença exigiria e afirma que a empresa não proíbe destilação, treinamento sobre as saídas do modelo, fine-tuning, PEFT (ajuste eficiente em parâmetros, como LoRA), quantização ou fusão de modelos. O card também diz que não modifica nem restringe a licença. Para quem já leu licenças "abertas" com teto de usuários ativos ou cláusula proibindo usar as saídas para treinar concorrentes, essa limpeza jurídica vale bastante.
501 bilhões guardados, 23 bilhões trabalhando
O Beam é um Mixture-of-Experts (MoE) esparso: em vez de passar cada token por todas as camadas densas, um roteador escolhe um pequeno subconjunto de "especialistas" (sub-redes feed-forward) para processá-lo. Pela tabela do card, são 501,3 bilhões de parâmetros totais e 23,4 bilhões ativos por token, distribuídos em 52 camadas, 3 densas e 49 MoE, com 256 especialistas. Lendo o arquivo de configuração, o S5 Labs concluiu que 8 especialistas ficam ativos por token. Esse número é uma leitura da configuração feita por terceiros, não algo que a Reflection declare na tabela.
A consequência prática é uma assimetria que costuma enganar quem chega ao tema pela primeira vez. Em computação por token, o Beam se parece com um modelo denso de uns 23 bilhões de parâmetros. Em memória, continua sendo um modelo de 501 bilhões, porque todos os especialistas precisam estar carregados: o roteador pode chamar qualquer um a qualquer momento. O MoE barateia a aritmética, não o armazenamento.
Na escala, o Beam fica na mesma família de projeto de outros MoE de pesos abertos já conhecidos, como o DeepSeek-V3 (671 bilhões totais, 37 bilhões ativos) e o Kimi K2 (1 trilhão totais, 32 bilhões ativos). A proporção de parâmetros ativos do Beam, perto de 4,7%, é das mais enxutas desse grupo.
A atenção combina Gated GQA e Sliding Window Attention. GQA (grouped-query attention) faz várias cabeças de consulta compartilharem as mesmas chaves e valores, o que reduz o tamanho do cache KV, a memória que guarda o contexto já processado. A janela deslizante limita parte das camadas a olhar só os tokens mais recentes. As duas escolhas existem para tornar viável o contexto declarado de 1 milhão de tokens, mas a Reflection não publicou quanto de memória o cache consome por token. Essa lacuna pesa justamente para quem quer usar o contexto longo.
Os demais itens do card: vocabulário de 152 mil tokens, só texto na entrada e na saída, data de corte do conhecimento em 30 de junho de 2026 e template de chat descrito como "Modified Harmony format". Harmony é o formato de conversa que a OpenAI definiu para os modelos gpt-oss. A palavra "modificado" sinaliza que reaproveitar parsers do gpt-oss sem conferir o template é pedir para quebrar tool calling em produção.
Um detalhe da documentação de raciocínio (abre em nova aba) muda a conta de custo: o Beam sempre raciocina. Não existe modo sem pensamento. O parâmetro reasoning_effort aceita low, medium, high, xhigh e max, e, se for omitido, vale o padrão do modelo. Dá para reduzir o raciocínio, não desligá-lo.
A conta do hardware
A gente costuma ler "pesos abertos" como "roda na minha máquina". Com o Beam, essa leitura só vale para máquinas bem específicas.
O exercício a seguir é aritmético, não um teste de implantação. Um nó com oito GPUs de 80 GB, configuração comum com H100, soma 640 GB, cerca de 596 GiB. O checkpoint BF16, com 933,81 GiB, não cabe. O FP8, com 468,72 GiB, cabe e deixa algo perto de 127 GiB para cache KV, ativações e a sobrecarga do runtime. Com contexto longo e vários usuários simultâneos, essa folga some rápido. O NVFP4, com 273 GiB, ocuparia quatro GPUs de 80 GB quase por inteiro, e por isso a configuração mínima realista provavelmente tem mais placas do que a divisão sugere.
O NVFP4 tem outro condicionante. É um formato de ponto flutuante de 4 bits criado pela Nvidia para a geração Blackwell, que executa essa precisão nativamente nos tensor cores. Em gerações anteriores, mesmo que o software consiga carregar os pesos, o ganho de computação do FP4 não aparece da mesma forma. A Reflection não documenta o comportamento do checkpoint NVFP4 fora da Blackwell, então quem tem parque Hopper deve tratar o FP8 como o alvo natural.
Sobre velocidade, há pouco a dizer com segurança. Nenhum material de lançamento traz tokens por segundo por precisão nem por configuração de nó. A única medida pública encontrada é a listagem do Vercel AI Gateway (abre em nova aba), que registra para o endpoint da própria Reflection 0,4 s, 432 tokens por segundo e 97%, sem detalhar a metodologia. É uma foto de um provedor num dia, não um benchmark de throughput.
O drafter DFlash2 é a aposta da Reflection para a latência. Na decodificação especulativa, um modelo pequeno, aqui com 1,93 bilhão de parâmetros, propõe uma sequência de tokens, e o modelo grande verifica todos de uma vez, aceitando os que concordam com o que ele próprio geraria. Quando a taxa de aceitação é alta, o modelo grande avança vários tokens por passada. O ganho depende do tipo de texto e não foi quantificado no lançamento. O drafter não funciona sozinho: serve apenas de acompanhante do Beam.
O suporte de software ajuda a reduzir o atrito. A Reflection anuncia suporte desde o primeiro dia em Transformers, vLLM, SGLang, Unsloth, Axolotl, TokenSpeed e Dynamo, da Nvidia, e cita Dell e HPE para implantações locais. "Suporte no dia zero" costuma significar que o modelo carrega e gera texto. Recursos como o NVFP4 e o drafter funcionarem bem juntos, em cada engine, é outra conversa, que só os issues dos repositórios vão contar.
Quanto custa pela API
Para quem não vai montar cluster, o Beam é um modelo de API como outro qualquer, com uma diferença: há vários fornecedores para os mesmos pesos, e eles competem em preço. A Reflection lista mais de 40 parceiros de lançamento, entre eles AWS, Google Cloud, Microsoft Foundry, Oracle, Together AI, Fireworks AI, Baseten, Nebius, CoreWeave, Cloudflare, Databricks, OpenRouter, Ollama e LM Studio. A própria API da Reflection está em beta pública, "gratuita para começar", sem preço por token publicado.
Os preços que existem por escrito vêm dos provedores:
| Provedor | Entrada (US$/1M tokens) | Entrada em cache (US$/1M) | Saída (US$/1M) | Contexto listado | Origem e data |
|---|---|---|---|---|---|
| Nebius | 0,25 | não listado | 1,00 | 1M | Vercel AI Gateway, 16/10/2026 |
| Together AI | 0,40 | 0,04 | 1,20 | ~1M | Página da Together AI, 17/10/2026 |
| Baseten | 1,30 | 0,13 (leitura) | 4,30 | 1M | Vercel AI Gateway, 16/10/2026 |
| Reflection | grátis (beta) | não listado | grátis (beta) | 1M | Vercel AI Gateway, 16/10/2026 |
A diferença entre o mais barato e o mais caro passa de cinco vezes na entrada e de quatro vezes na saída, pelos mesmos pesos. Há ainda uma divergência de contexto que pode morder na integração: o Vercel descreve o modelo no gateway com janela de 262.144 tokens e até 131.072 tokens de saída, enquanto as linhas de cada provedor mostram 1 milhão. Quem planeja documentos enormes deve confirmar o limite efetivo no endpoint que vai chamar.
Um cálculo hipotético ajuda a ver o que pesa. Suponha uma tarefa de agente de programação que envia 200 mil tokens de entrada e recebe 30 mil de saída. Na tabela da Together AI (abre em nova aba), sem cache, ela sai por cerca de US$ 0,12 (US$ 0,08 de entrada e US$ 0,036 de saída). Na Baseten, por cerca de US$ 0,39. Se boa parte daqueles 200 mil tokens for contexto repetido entre chamadas, como acontece em agentes que reenviam o histórico, a entrada em cache a US$ 0,04 por milhão derruba esse componente para uma fração.
E tem a saída. Como o Beam sempre raciocina, parte dos tokens de saída é pensamento que o usuário talvez nem veja, mas que entra na fatura. Na Together, a saída custa três vezes a entrada. É aqui que entra a alegação mais interessante, e menos verificada, do card: segundo a Reflection, o Beam atinge qualidade comparável à dos principais modelos abertos usando cerca de três vezes menos tokens de raciocínio. Se isso se confirmar nas suas cargas, o custo real por tarefa pode ser bem menor do que a tabela de preço por token sugere. Se não se confirmar, a tabela engana para o outro lado. O card não nomeia nenhum avaliador independente para essa afirmação.
O que os benchmarks dizem, e o que deixam de dizer
Todos os números abaixo são da Reflection, medidos com temperatura 0,7 e top_p 0,99 nos checkpoints instruídos:
| Benchmark | BF16 | FP8 | NVFP4 |
|---|---|---|---|
| SWE-bench Verified | 81,6% | 80,2% | 80,7% |
| SWE-Bench Pro v1 | 66,1% | 65,9% | 65,6% |
| SWE-Bench Pro v2-Hard | 76,5% | 78,4% | 78,6% |
| Terminal Bench v2.1 | 80,1% | 78,9% | 78,4% |
| SWE-bench Multilingual | 78,3% | 78,1% | 77,5% |
| DeepSWE v1.1 | 43,3% | 43,0% | 42,7% |
| AIME 2026 | 97,7% | 98,0% | 97,5% |
| GPQA Diamond | 90,6% | 90,3% | 89,3% |
| HLE sem ferramentas | 36,0% | 36,0% | 34,8% |
No HLE com ferramentas, a empresa informa 51,1% nas três precisões.
A linha do SWE-Bench Pro v2-Hard é a mais reveladora, e não pelo valor absoluto. As versões quantizadas pontuam acima da BF16, mais de dois pontos no caso do NVFP4. Quantizar não deixa um modelo mais inteligente. A explicação mais provável é variância de amostragem: com temperatura 0,7, duas rodadas do mesmo modelo dão resultados diferentes, e diferenças de um ou dois pontos podem ser ruído puro. Daí sai uma leitura dupla. A boa notícia é que, nesses testes, as versões FP8 e NVFP4 não mostram perda mensurável. A ressalva é que os testes, do jeito que foram reportados, também não conseguiriam detectar uma perda pequena. Sem o relatório técnico, não se sabe quantas execuções sustentam cada número nem qual o intervalo de confiança.
Nos benchmarks de engenharia de software, o andaime do agente pesa tanto quanto o modelo, e a pontuação depende de como o agente navega no repositório, roda testes e decide parar. A comparação direta com números de outros laboratórios, medidos com andaimes e orçamentos de tokens diferentes, é frágil por construção. O nome também engana: o SWE-bench Multilingual mede tarefas em várias linguagens de programação, não em idiomas humanos.
Sobre idiomas, o card é direto: o Beam foi desenvolvido predominantemente para inglês, e o repositório traz só a etiqueta English. Não há resultado publicado de desempenho em outras línguas. Quem pretende atender usuários em português, ou escrever prompts em português para agentes, vai ter que medir isso por conta própria.
As avaliações de segurança têm um número que merece mais atenção do que costuma receber. Na bateria Iris, da Reflection, o modelo BF16 recusa ou redireciona 88,9% dos pedidos nocivos e atende 81,5% dos pedidos inofensivos. Lido pelo avesso, cerca de um em cada cinco pedidos legítimos dessa bateria não foi atendido integralmente. Para um assistente de uso geral, essa taxa de recusa excessiva aparece no dia a dia. Para um agente de código que raramente esbarra em temas sensíveis, provavelmente pesa menos, mas é uma inferência, não uma medição.
Treinado dentro de um terminal
O Mirror CLI, em beta segundo a documentação, é descrito pela Reflection como o harness, o ambiente de execução de agente, em que o Beam foi treinado. A empresa diz que também testou o modelo com Pi, OpenCode e Hermes, este da Nous Research.
A escala do treinamento por reforço explica a ênfase. A Reflection afirma ter rodado cerca de 1,3 bilhão de sandboxes nas maiores execuções de RL, com pico de 883.006 vCPUs numa única hora, 83% da capacidade alocável, espalhadas por 23 clusters no Google Cloud e na AWS. É um volume pesadíssimo de execução de código real: o modelo aprendeu agindo em ambientes isolados, observando resultados e sendo recompensado por eles.
Disso sai uma inferência prática. Modelos treinados por reforço num harness específico tendem a render melhor nele, porque aprenderam suas convenções de ferramentas, formato de saída e critérios de parada. Publicar o Mirror CLI junto com os pesos é, portanto, mais do que um brinde. É entregar o ambiente onde os números foram produzidos. Quem plugar o Beam num agente próprio, com outro conjunto de ferramentas, deve esperar alguma distância em relação ao que o card mostra, sem que haja medida pública de quanto.
O perfil declarado pela Reflection, código avançado, raciocínio e tarefas agênticas de longo horizonte, combina com tudo isso: contexto de 1 milhão de tokens, raciocínio obrigatório, ênfase em SWE-bench e Terminal Bench, treinamento massivo em sandbox. Chat casual de baixa latência é justamente o caso em que o raciocínio sempre ligado mais atrapalha.
O que decidir, e para quem
Há três decisões distintas aqui, e misturá-las leva a contas erradas.
A primeira é usar o Beam ou não. Isso depende de ele resolver suas tarefas melhor ou mais barato do que o modelo atual, e a resposta honesta, um dia após o lançamento, é que só seus próprios testes dizem. Os números da Reflection são um bom motivo para testar, não para migrar.
A segunda é API ou infraestrutura própria. Para a maioria, API. A diferença de preço entre provedores já é uma alavanca maior do que a maioria das otimizações de prompt, e a API da Reflection está grátis na beta. A infraestrutura própria faz sentido em condições específicas:
- dados que não podem sair do seu perímetro, por contrato ou regulação;
- volume alto e estável o bastante para ocupar um nó o tempo todo;
- necessidade de fine-tuning ou destilação, que a licença permite sem ressalvas;
- equipe que já opera vLLM, SGLang ou Dynamo em produção.
Sem custo de hardware e sem throughput por nó documentados, ninguém consegue calcular honestamente o ponto de equilíbrio entre comprar tokens e operar GPUs. A conta precisa ser feita com o seu preço de GPU e a sua carga.
A terceira é qual precisão. Pelos números divulgados, FP8 em Hopper e NVFP4 em Blackwell parecem não custar qualidade relevante, com a ressalva estatística já discutida. BF16 serve sobretudo como base para fine-tuning e como referência de avaliação.
O contraponto mais consistente vem do próprio cronograma. O Beam saiu com pesos, licença limpa e ecossistema largo, mas sem relatório técnico e sem avaliação independente. Na página do Hugging Face, no momento da coleta, o modelo não aparecia implantado por nenhum Inference Provider da plataforma, embora dezenas de parceiros o oferecessem por fora. A disponibilidade comercial veio antes da verificação. Adotar cedo traz a vantagem da beta gratuita e o risco de construir em cima de números que ninguém de fora reproduziu.
Onde o Beam 1.0 fica, por enquanto
Duas coisas estão comprovadas. A licença é genuinamente permissiva, e os pesos estão públicos em três precisões, com drafter e harness. Isso já coloca o Beam entre as opções mais livres da faixa dos 500 bilhões de parâmetros, e qualquer equipe pode auditá-lo, destilá-lo ou servi-lo sem pedir licença a ninguém.
O resto ainda é alegação ou possibilidade. O desempenho em código vem de medições internas, com amostragem que não permite separar sinal de ruído em diferenças pequenas. A economia de tokens de raciocínio, que decide o custo real num modelo que sempre pensa, vem da Reflection e de mais ninguém. O custo de rodar localmente parte de uns 273 GiB só de pesos no formato mais compacto, que depende de GPUs Blackwell para render o que promete. O desempenho fora do inglês não foi documentado.
Para um time técnico, o caminho sensato é tratar o Beam como candidato forte a teste, não como substituto automático. Rodar a mesma bateria de tarefas reais em dois ou três provedores e em pelo menos dois níveis de reasoning_effort, contando tokens de saída por tarefa, responde em poucos dias o que o card ainda não responde. O relatório técnico, quando sair, e as primeiras avaliações de terceiros vão dizer se os números se sustentam. Até lá, a licença é o único item do lançamento que dispensa medição.
Perguntas frequentes
Posso usar o Beam 1.0 em produto comercial e treinar outros modelos com ele?
Sim. Os pesos estão sob Apache 2.0, que permite uso comercial, modificação e redistribuição, e o model card afirma que a Reflection não proíbe destilação, treinamento sobre as saídas, fine-tuning, PEFT, quantização ou fusão de modelos.
Qual é o mínimo de memória para rodar o modelo localmente?
A versão mais compacta, em NVFP4, tem cerca de 273 GiB só de pesos, sem contar cache KV e ativações. A FP8 tem cerca de 469 GiB e a BF16, cerca de 934 GiB. O NVFP4 foi projetado para GPUs Blackwell; em Hopper, o FP8 é o alvo mais natural.
Existe acesso gratuito por API?
A API da Reflection está em beta pública descrita como gratuita para começar, sem preço por token publicado. Provedores como Together AI, Nebius e Baseten cobram, com preços de saída entre US$ 1,00 e US$ 4,30 por milhão de tokens nas listagens de 16 e 17 de outubro de 2026.
O Beam 1.0 funciona bem em português?
Não há dado publicado. O model card informa que o modelo foi desenvolvido predominantemente para inglês, e o benchmark chamado Multilingual mede linguagens de programação, não idiomas humanos. O desempenho em português precisa ser testado por quem for usá-lo.