
A utilização de modelos de linguagem para avaliar outros modelos de linguagem, paradigma conhecido como LLM-as-a-Judge, estabeleceu-se como a abordagem padrão para benchmarks automatizados, monitoramento de produção e alinhamento via aprendizado por reforço. No entanto, submeter milhões de pares de respostas a avaliadores generativos de fronteira impõe um gargalo financeiro e computacional insustentável. Quando cada julgamento exige centenas de tokens de raciocínio verbalizado gerados por modelos de ponta, o custo por requisição e a latência de inferência inviabilizam rotinas de validação contínua em larga escala.
Para enfrentar esse dilema entre a fidelidade do julgamento e a restrição orçamentária, pesquisadores da Carnegie Mellon University (Yubo Li, Yidi Miao, Ramayya Krishnan e Rema Padman) investigaram o comportamento de modelos avaliadores focados estritamente em decisões. Documentado no paper JEV-as-a-Judge: Accept When Confident, Escalate When Unsure (abre em nova aba), o estudo analisa o framework JEV (desenvolvido pela TypeSafe AI) e demonstra como uma cascata de inferência baseada em métricas calibradas de incerteza consegue reter 99% da precisão de um modelo de fronteira operando com apenas 57% do seu custo financeiro.
Compreender o funcionamento prático dessa arquitetura exige analisar como a avaliação estritamente decisória opera, quais limites probabilísticos governam o roteamento e onde se situam as fragilidades estruturais que impedem o uso irrestrito de juízes compactos.
O problema do custo e da latência em juízes generativos
Em pipelines tradicionais de avaliação, um modelo generativo recebe o prompt original e duas respostas candidatas, sendo instruído a emitir uma justificativa detalhada (Chain-of-Thought) antes de declarar o vencedor. Esse formato acarreta um custo duplo. Em primeiro lugar, consome dezenas ou centenas de tokens de saída a preços elevados de modelos de ponta. Em segundo lugar, a latência de resposta se expande para a casa dos segundos, inviabilizando decisões síncronas em sistemas em tempo real.
Conforme os dados apresentados pelos pesquisadores da Carnegie Mellon University, submeter avaliações diretamente a um avaliador de ponta como o GPT-6 custa US$ 12,182 por 1.000 julgamentos, registrando uma latência mediana de 1,885 segundos por inferência. Em operações contínuas de monitoramento ou ciclos de Reinforcement Learning from AI Feedback (RLAIF), nos quais centenas de milhares de pares são avaliados por ciclo, esse patamar de custo se torna o principal componente de despesa do pipeline.
A alternativa imediata observada na indústria consistia em recorrer a modelos menores e abertos ou juízes hospedados de baixo custo. Contudo, essa substituição direta gera perda de acurácia, suscetibilidade a vieses de tamanho de resposta e dificuldade em identificar respostas factualmente errôneas mas bem redigidas. O JEV propõe contornar esse dilema não substituindo integralmente o modelo superior, mas atuando como uma primeira camada de triagem decisória calibrada.
Arquitetura do JEV e o modelo decision-only
Diferente de avaliadores conversacionais que emitem justificativas textuais completas, o JEV é configurado como um decision-only judge (juiz focado exclusivamente na decisão). Ele recebe as entradas comparativas e retorna de maneira direta o veredito acompanhado da distribuição de probabilidade atribuída a cada rótulo de saída.
Ao eliminar a geração de cadeias explicativas de texto, o modelo reduz drasticamente os ciclos de computação necessários na decodificação. Os dados do estudo indicam que o JEV atinge uma latência mediana de 0,152 segundos por julgamento, sendo aproximadamente doze vezes mais rápido que o GPT-6. No quesito financeiro, o custo é de US$ 0,044 por 1.000 julgamentos, o equivalente a 0,36% da tarifa cobrada pelo modelo de fronteira, uma redução de custo da ordem de 277 vezes.
A ausência de geração de texto, todavia, altera as dinâmicas de observabilidade. Em vez de analisar o encadeamento lógico verbalizado pelo avaliador, os desenvolvedores trabalham com a incerteza estatística expressa diretamente nas probabilidades dos rótulos. O cerne do método reside em como utilizar essa probabilidade para orquestrar a delegação de tarefas complexas.
A mecânica de 'Accept when confident, escalate when unsure'
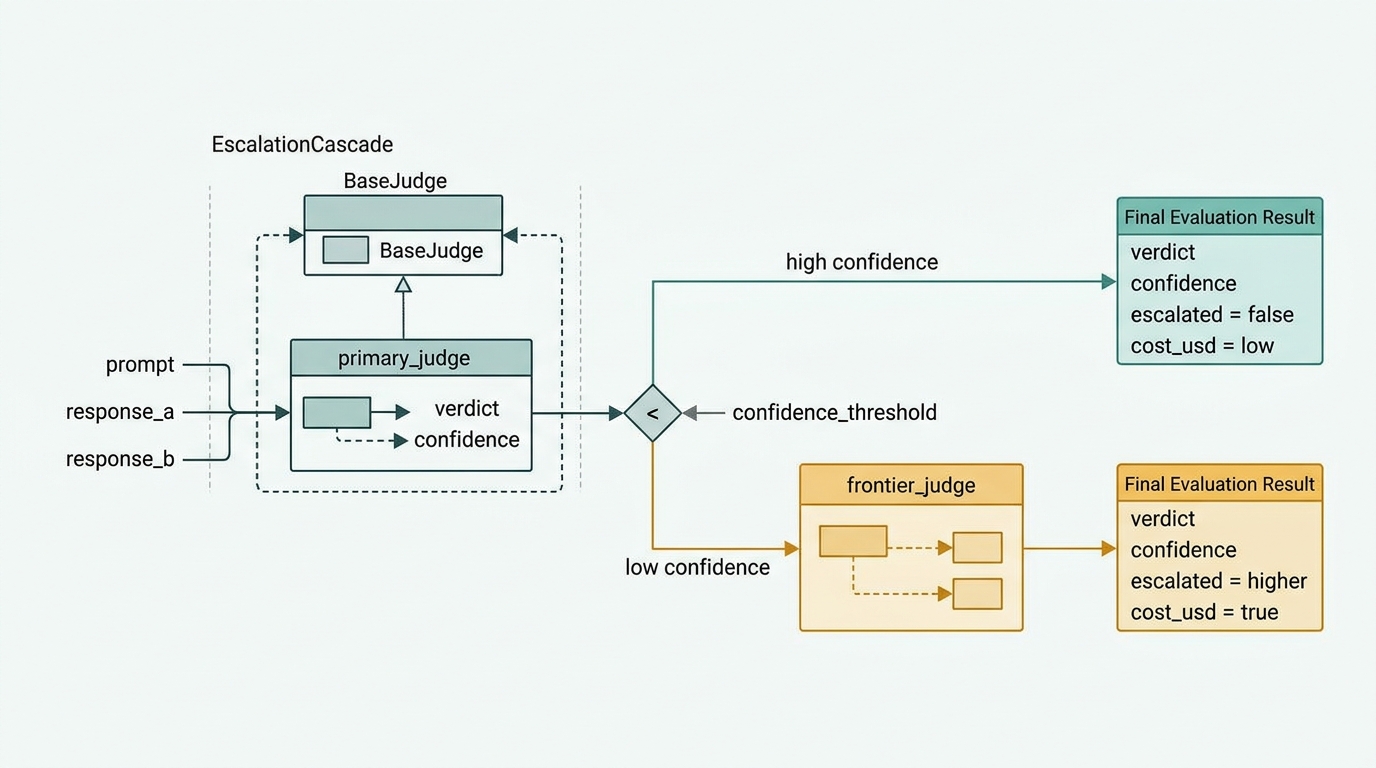
O princípio operacional do JEV fundamenta-se em uma cascata congelada (frozen cascade). Esse arranjo de engenharia encadeia dois sistemas de inferência sem recalibrar ou ajustar pesos de redes em tempo de execução:
- O par de respostas e seu contexto são submetidos inicialmente ao JEV.
- O sistema extrai a predição da classe e o valor de probabilidade do rótulo vencedor.
- Caso a probabilidade associada supere um limiar predefinido de confiança ($P \ge \tau$), o veredito do JEV é aceito como decisão final do pipeline.
- Caso a probabilidade permaneça abaixo do limiar ($P < \tau$), a predição é descartada e a consulta é escalada integralmente para o modelo generativo mais caro (GPT-6 Astra).
O ponto central identificado na pesquisa disponibilizada no alphaXiv (abre em nova aba) é que a disparidade de desempenho entre o JEV e os modelos de fronteira não se distribui de maneira homogênea ao longo do conjunto de dados. Ela se concentra quase integralmente nos casos em que o próprio JEV atribui baixa probabilidade à sua decisão.
Para determinar o limiar de escalonamento, os pesquisadores testaram diferentes cortes de confiança. O patamar de $\tau = 0,9$ revelou-se o equilíbrio ideal entre custo e retenção de qualidade técnica. Abaixo dessa marca, a probabilidade de divergência em relação a julgamentos humanos e a modelos de ponta cresce substancialmente.
O algoritmo a seguir ilustra a lógica de orquestração dessa cascata congelada em um ambiente de produção:
from dataclasses import dataclass
from typing import Optional, Protocol

@dataclass(frozen=True)
class EvaluationResult:
    verdict: str
    confidence: float
    escalated: bool
    cost_usd: float

class BaseJudge(Protocol):
    def evaluate(self, prompt: str, response_a: str, response_b: str) -> tuple[str, float]:
        ...

class EscalationCascade:
    def __init__(
        self,
        primary_judge: BaseJudge,
        frontier_judge: BaseJudge,
        confidence_threshold: float = 0.90,
        primary_cost_per_eval: float = 0.000044,
        frontier_cost_per_eval: float = 0.012182,
    ) -> None:
        self.primary_judge = primary_judge
        self.frontier_judge = frontier_judge
        self.threshold = confidence_threshold
        self.primary_cost = primary_cost_per_eval
        self.frontier_cost = frontier_cost_per_eval

    def adjudicate(self, prompt: str, response_a: str, response_b: str) -> EvaluationResult:
        verdict, confidence = self.primary_judge.evaluate(prompt, response_a, response_b)

        # Aceita a decisão se a confiança atingir o limiar
        if confidence >= self.threshold:
            return EvaluationResult(
                verdict=verdict,
                confidence=confidence,
                escalated=False,
                cost_usd=self.primary_cost,
            )

        # Escala para o modelo de fronteira quando houver incerteza
        frontier_verdict, frontier_confidence = self.frontier_judge.evaluate(
            prompt, response_a, response_b
        )
        return EvaluationResult(
            verdict=frontier_verdict,
            confidence=frontier_confidence,
            escalated=True,
            cost_usd=self.primary_cost + self.frontier_cost,
        )
Essa estrutura de controle converte a distribuição probabilística da inferência primária em uma salvaguarda contra decisões precipitadas de um modelo de menor porte.
Desempenho empírico e redução de custos operacionais
Os testes conduzidos pelos pesquisadores da Carnegie Mellon University compararam o JEV contra dezesseis juízes generativos e modelos de recompensa (reward models), submetendo os casos discrepantes a adjudicação humana duplo-cega. A avaliação contemplou tarefas de preferência comum, facticidade contextualizada e problemas estruturados de raciocínio.
Na análise de preferências cotidianas e facticidade orientada a evidências, o JEV operando de forma autônoma manteve-se a uma distância de até três pontos percentuais do GPT-6. No conjunto de 400 pares do benchmark RewardBench, o JEV alcançou 92,2% de acurácia contra 93,5% do GPT-6 Astra, registrando uma diferença pareada de -1,25 pontos percentuais (com intervalo de agrupamento de 95% entre -3,8 e 1,5).
No benchmark HaluEval, focado em detectar alucinações factuais, o JEV atingiu 87,5%, superando levemente a marca de 86,7% obtida pelo GPT-6, com uma variação de +0,83 pontos (intervalo de confiança entre -1,25 e 2,92). Na adjudicação de respostas finais diretas, obteve 94,0% frente aos 96,7% do comparador. Entre os avaliadores hospedados com custo inferior a US$ 1 por mil requisições, o JEV registrou a maior acurácia no JudgeBench.
| Avaliador / Arquitetura | Custo por 1k julgamentos | Latência mediana | RewardBench | HaluEval | JudgeBench |
|---|---|---|---|---|---|
| JEV (Stand-alone) | US$ 0,044 | 0,152 s | 92,2% | 87,5% | 78,6% |
| GPT-6 (Frontier) | US$ 12,182 | 1,885 s | 93,5% | 86,7% | 93,1% |
| Cascata JEV + GPT-6 ($\tau \ge 0,9$) | ~US$ 6,940 | Mista (0,152s / 1,885s) | 92,5%* | Não medido em conjunto | Dependente de escalonamento |
\ Medição reportada no conjunto de teste de 510 pares de preferência retidos.*
Quando o mecanismo de escalonamento com limiar de confiança em 0,9 foi aplicado a um conjunto de 510 pares de preferência retidos (held-out preference pairs), a precisão conjunta da cascata atingiu 92,5%, ante os 93,1% obtidos pelo GPT-6 isolado. Esse resultado preservou 99,35% da precisão do modelo de fronteira, demandando cerca de 57% do investimento financeiro total que seria consumido caso o GPT-6 avaliasse todas as amostras.
Os dados consolidados no sumário do DAIR.AI Academy (abre em nova aba) evidenciam que aproximadamente 43% do custo foi eliminado simplesmente descartando a intervenção do modelo de ponta nos casos em que a probabilidade interna do juiz primário superava noventa por cento.
Vetores de falha, viés e limitações técnicas
Apesar da eficiência em tarefas com forte ancoragem factual ou preferências distributivas convencionais, o estudo identifica limites severos na capacidade avaliativa do JEV isolado. Esses limites explicam a necessidade mandatória da arquitetura em cascata com escalonamento.
As deficiências do JEV tornam-se críticas em dois cenários específicos: verificação de derivações passo a passo e resistência a respostas incorretas com redação prolixa.
Em tarefas do benchmark JudgeBench que demandavam validação formal de etapas intermediárias de cálculo ou lógica, o JEV registrou 78,6% de acurácia, frente aos 93,1% obtidos pelo GPT-6, abrindo uma desvantagem de 14,5 pontos percentuais. O cenário se repete de forma ainda mais acentuada no subconjunto difícil do RM-Bench (RM-Bench hard), no qual o modelo alcançou 74,8% contra 94,6% do modelo de fronteira, uma lacuna de 19,8 pontos percentuais.
Taxas de acurácia em tarefas complexas:

JudgeBench (Raciocínio e etapas lógicas):
[JEV: 78,6%]                  |========> (-14,5%)
[GPT-6: 93,1%]                |===================>

RM-Bench hard (Respostas prolixas incorretas):
[JEV: 74,8%]                  |=======> (-19,8%)
[GPT-6: 94,6%]                |====================>
A raiz dessa defasagem reside na natureza do modelo focado exclusivamente em decisão. Sem alocar parâmetros e ciclos de decodificação para desenrolar uma cadeia explícita de raciocínio passo a passo, o avaliador compacto torna-se vulnerável ao viés de prolixidade (verbosity bias) e à plausibilidade superficial. Se uma resposta incorreta for apresentada com gramática impecável, tom confiante e formatação organizada, a representação latente do avaliador compacto pode associar esses elementos a alta probabilidade de acerto, falhando em checar se a derivação matemática ou dedutiva quebrou regras elementares na metade do desenvolvimento.
Outro fator limitante é a ausência de rastreabilidade explicativa. Como o sistema fornece apenas vereditos e pontuações de probabilidade, equipes de engenharia de dados perdem a capacidade de auditar o raciocínio subjacente a um erro sem envolver intervenção humana direta ou reavaliação via modelos generativos. Para monitoramento de auditoria e conformidade (compliance), o resultado probabilístico isolado oferece suporte explicativo limitado quando comparado a um relatório com anotações analíticas.
Critérios de decisão para arquitetura em produção
A decisão de adotar a cascata de verificação baseada no JEV depende essencialmente das características de tráfego, requisitos de latência e profundidade lógica das avaliações demandadas pela aplicação. O método não deve ser interpretado como substituto universal de juízes generativos de grande porte, mas como uma técnica de roteamento por incerteza.
Engenheiros e arquitetos de soluções podem estruturar a seleção de componentes em torno de três parâmetros operacionais:
- Volume massivo com restrição de custo e dominância de facticidade: Em pipelines de classificação de preferência geral, moderação primária de respostas ou alinhamento de estilo, o JEV operando de forma autônoma entrega resultados muito próximos aos do GPT-6 por uma fração insignificante do custo (US$ 0,044 contra US$ 12,182 por mil avaliações).
- Avaliação contínua em escala mista: Em fluxos de validação de produtos de inteligência artificial em produção, a cascata configurada no limiar de corte de 0,9 oferece uma relação equilibrada. A retenção das requisições mais evidentes no primeiro estágio gera economia financeira de aproximadamente 43%, preservando a integridade do índice de acerto nos 57% restantes escalados para o modelo de ponta.
- Validação estrita de cadeias de raciocínio: Se o pipeline avalia deduções formais, provas matemáticas ou compilação de rotinas complexas de software, a probabilidade do modelo compacto não isola perfeitamente todas as alucinações de raciocínio profundo. Nesses casos, o desvio de 14 a 20 pontos percentuais observado no JudgeBench e no RM-Bench desaconselha o uso do modelo compacto como filtro primário, a menos que testes preliminares confirmem a calibração da incerteza para a distribuição exata dos seus dados.
O estudo publicado pela equipe da Carnegie Mellon University, cujas métricas e distribuições também podem ser acompanhadas na página do trabalho no Hugging Face (abre em nova aba), consolida a viabilidade de sistemas híbridos de avaliação. Ao converter incerteza em critério explícito de roteamento, a engenharia de sistemas de avaliação baseados em modelos de linguagem avança da escolha binária entre custo e acurácia para uma governança dinâmica de recursos computacionais.