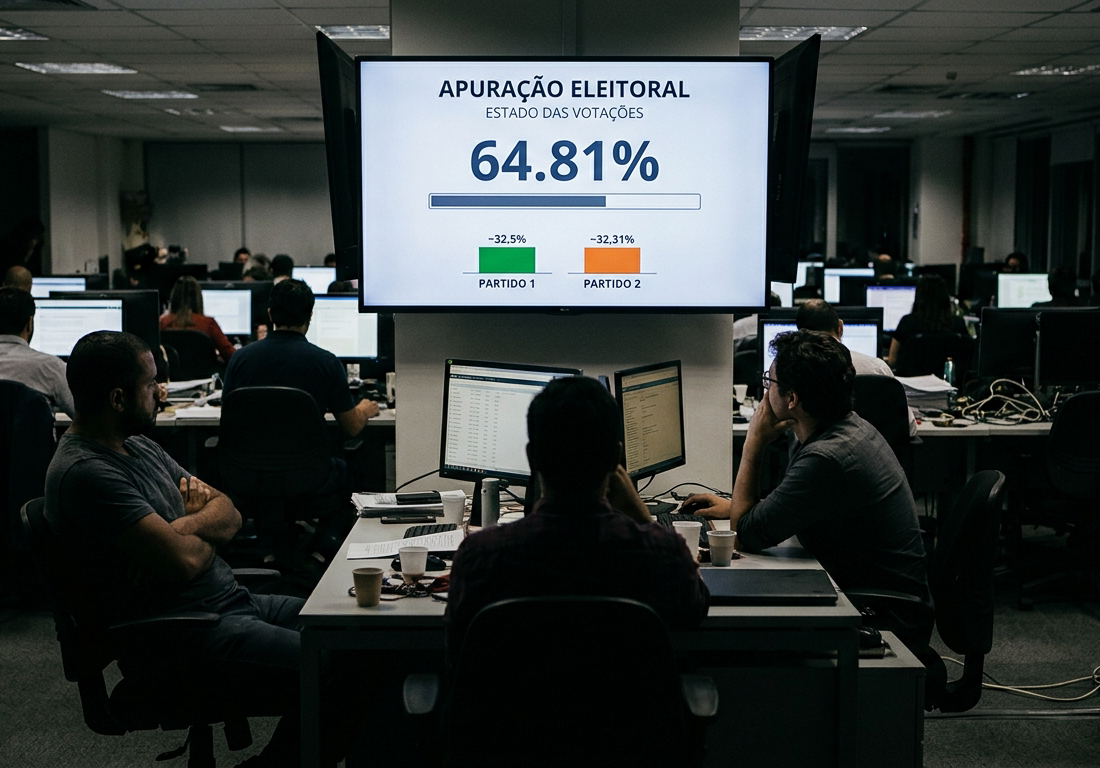
A tela parou em 64,81%. Eram 19h14 de 4 de outubro, na visualização Brasil do painel de resultados do TSE, e o percentual para presidente e vice ficou congelado até as 20h04. Cinquenta minutos de número imóvel na noite mais monitorada do país.
A explicação oficial veio depois: uma contenção no processamento, provocada pelo aumento súbito do volume de dados, paralisou o módulo que gera os arquivos de divulgação desses dois cargos na visualização Brasil. A visualização estadual não parou, os votos continuaram subindo aba por aba. A totalização seguiu normalmente, com uma breve suspensão prevista em protocolo de segurança. A Secretaria de Tecnologia da Informação do TSE abriu investigação na mesma noite, com meta declarada de que a falha não se repita no segundo turno, em 25 de outubro. A Agência Brasil registrou o posicionamento do tribunal: o erro foi na divulgação, a última etapa, quando os votos já estavam contabilizados.
Explicação oficial, porém, chegou dias depois. A tela congelada chegou primeiro. No intervalo, modelos de linguagem foram consultados, geraram tabelas, resumos e interpretações sobre um evento que não conseguiam ver. O que sai disso está documentado, erro por erro.
Os números por trás da tela parada
O projeto de leitura da apuração de 2026 (abre em nova aba) processou os 499.192 boletins de urna publicados pelo TSE, 6,55 GB de arquivos. Apenas 15 seções ficaram sem arquivo publicado, deixando 3.935 votos presidenciais fora da comparação. Entre os arquivos públicos e as páginas capturadas do painel, 99,96% das comparações por município e cargo bateram voto por voto.
Duas curvas explicam a noite melhor que qualquer narrativa. A primeira: a vantagem na parcial começou em 10,55 pontos com 10% das seções apuradas e terminou em 1,87, queda de 8,7 pontos. A ordem de entrada das regiões explica 69% dessa variação. No primeiro turno de 2022 a queda tinha sido de 10,7 pontos, e o líder da parcial virou. A segunda: a queda começou às 17h58, mais de uma hora antes de a tela parar. Quem olhou o movimento completo viu uma curva dentro do padrão histórico, não um corte.
O ponto fora da curva foi outro. Nenhum boletim foi registrado das 19:31:50 às 19:59:22, um buraco de 27,5 minutos na ingestão. Depois entraram 20.171 boletins em seis minutos, com pico de 5.119 por minuto. Uma captura independente do painel registra bordas ligeiramente diferentes das oficiais, 19h06 e 20h08; a diferença é de janela de observação, não de causa.
| Métrica | 1º turno de 2022 | 1º turno de 2026 |
|---|---|---|
| Maior intervalo sem boletim registrado | 7,4 min | 27,5 min |
| Pico de boletins por minuto | 3.791 | 5.119 |
| Queda da vantagem na parcial | 10,7 pontos, com virada | 8,7 pontos, sem virada |
A leitura registrada no projeto é taxativa: em tudo o que os dados públicos mostram, a apuração de 2026 se comportou como a de 2022. O único anomalo são os 27,5 minutos sem boletim. Eles pedem explicação, o TSE reconheceu o problema de divulgação, mas nenhum boletim sumiu. A soma fecha, e o buraco tem explicação pendente, não destino misterioso.
Onde a IA errou
O mesmo projeto mantém um registro público de correções (abre em nova aba) dos erros cometidos pela IA que executou a análise. Vale ler como catálogo de modos de falha.
- Atribuição partidária e inferência política erradas. Na noite de 5 de outubro, o texto tratava Tarcísio como filiado ao Republicanos, e não ao PL, e concluiu que o partido separava os campos políticos dele e de Flávio. Tarcísio é apoiador declarado de Flávio. O modelo errou o fato e construiu uma leitura política em cima do fato errado.
- Números que não existiam. Uma tabela de 14 pontos da tela veio de um resumo automático da página de um blog ao vivo, trazendo decimais e horários ausentes da página capturada, como 21,96%, 88,46% e 90,61%. A tabela foi refeita só com o que estava escrito de verdade.
- Divergência fabricada por snippet. Tocantins ficou fora da classe de referência de 2022 porque um trecho de resultado de busca divergia das fontes. O problema não estava nos dados, estava no intermediário.
- Limites de dados históricos. O plano citava 2014, 2018 e 2022 para a curva histórica. O 2018 não tem o campo de horário de recebimento do boletim (
DT_BU_RECEBIDO) e o 2014 não tem cabeçalho nem hora. Só 2022 serviu. - Inferência ecológica estourada. Inferência ecológica é estimar comportamento individual a partir de dados agregados. A estimativa para São Paulo somava 13,45 milhões de votos para Flávio contra 12,92 milhões reais, 4% a mais. Refeita, a transferência estimada de Tarcísio para Flávio caiu de 90% para 87%. A diferença final entre os dois, recalculada, deu 1.569.632 votos; o arquivo oficial do TSE registra 1.569.851 (14.491.874 contra 12.922.023).
O erro com decimais é o mais instrutivo para quem trabalha com LLM. O modelo recebeu um resumo de um resumo e devolveu números com precisão que nenhuma das duas camadas tinha. Não foi adivinhação maliciosa, foi completude plausível: o formato da resposta estava certo, o conteúdo não. É a definição operacional de alucinação, a geração de detalhes específicos com aparência de dado verificado.
O resto é consequência de arquitetura. Um modelo de linguagem tem corte de conhecimento, a data limite dos dados de treinamento, e não sabe nada do que aconteceu depois dela. Sem ferramentas de consulta, ele não vê o painel do TSE, vê apenas o que o prompt traz. Cada intermediário entre a fonte primária e a resposta é uma chance nova de erro, e a IA errou feio justamente nos pontos em que o intermediário era um blog ao vivo resumido automaticamente.
O vácuo que a desinformação preencheu
Enquanto a tela estava parada, circularam mensagens e vídeos afirmando fraude no resultado da presidência. A checagem do próprio TSE (abre em nova aba) classifica a informação como falsa e repete a causa técnica da pausa. A Agência Lupa (abre em nova aba) verificou um vídeo em que números falsos subiam ao lado da fala de um homem; em nota, o TSE afirmou que a imagem do post é 100% falsa e não foi produzida com dados da Justiça Eleitoral.
O mecanismo é simples e vai se repetir. Um evento visível a milhões de pessoas, uma tela parada, uma explicação oficial que demora. O vácuo não fica vazio. Preenche com o que aparecer primeiro, e o que aparece primeiro raramente é o boletim de urna, é o vídeo com número inventado rodando em baixo da fala. A Agência Brasil (abre em nova aba) registrou o detalhe que serve de contraprova: nas abas estaduais, os votos para presidente continuaram subindo durante todo o episódio. A informação correta estava a um clique da errada, mas a errada era mais fácil de compartilhar.
Para quem desenvolve, o risco é duplo. Painéis, bots de apuração e resumos automáticos são construídos por técnicos, e a falha de um pipeline ganha credibilidade instantânea quando sai de uma interface com cara de dado oficial. O vídeo verificado pela Lupa fazia exatamente isso: superponha um gráfico falso a uma fala, e o gráfico empresta autoridade à fala.
O que fica para quem constrói pipeline
As falhas documentadas na noite de 4 de outubro formam uma lista de mitigação aplicável a qualquer sistema que consuma dados eleitorais ao vivo.
- Fonte primária sempre. Arquivos públicos de boletim, não resumo de blog. Se o intermediário for inevitável, registre a origem de cada número.
- Valide precisão contra a captura. Um decimal que a fonte não contém é sinal de alucinação, não de dado adicional. A tabela com 21,96% deveria ter sido barrada por um teste simples de consistência com a página capturada.
- Monitore lacunas de ingestão. O buraco de 27,5 minutos era detectável em tempo real por um contador de boletins por minuto. Um alerta teria transformado pânico em telemetria.
- Use baseline histórico. A comparação com 2022, pico de 3.791 boletins por minuto e maior intervalo de 7,4 minutos, transformou uma anomalia em contexto. Sem baseline, todo ruído parece fraude.
- Separe as camadas. Contabilização, totalização e divulgação são etapas distintas. A falha de 2026 foi na última; confundi-las no texto ou no código produz a acusação errada.
- Publique correções. O registro de erros do projeto é a parte mais crível do material. Transparência sobre o próprio erro é o que separa análise de propaganda.
O segundo turno de 25 de outubro é o próximo teste, com a investigação do TSE ainda em curso e a mesma arquitetura de ingestão sob pressão maior, porque um turno decisivo multiplica atenção e volume. A lição central da noite de 4 de outubro não é que a IA errou, qualquer pipeline errou em algum nível, mas que o erro fica caro quando não há dado verificável no meio do caminho. Quem tem boletim, captura e contador de lacunas define a narrativa do vácuo. Quem não tem, deixa o espaço para o gráfico falso.