
A Anthropic (abre em nova aba) está conversando com escritórios de advocacia para entender como advogados negociam em nome de clientes sem abrir mão de resultados justos. O Financial Times publicou a informação em 18 de outubro, com base em duas pessoas próximas à empresa. O objetivo é formular "normas de negociação" para agentes do Claude que vão pechinchar preço, contestar uma cobrança ou melhorar uma proposta de aluguel ou de emprego. A empresa não anunciou a iniciativa. Publicou, porém, duas peças que explicam o movimento melhor do que a reportagem: um experimento de mercado entre agentes, em setembro, e uma vaga de fellowship para pesquisadores de direito e humanidades.
A leitura óbvia é ética: a Anthropic quer que seus agentes não mintam nem manipulem. É verdade, mas é a parte menos interessante. A leitura que me parece correta trata de onde o comportamento mora. Os dados da própria empresa indicam que, numa negociação, o modelo pesa mais do que as instruções que recebe. Se isso vale, normas de negociação não podem ser um parágrafo de system prompt que cada desenvolvedor escreve do seu jeito. Elas precisam estar no treinamento. E quem treina o modelo passa a escrever as regras do mercado em que esses agentes se encontram.
O experimento que muda o problema
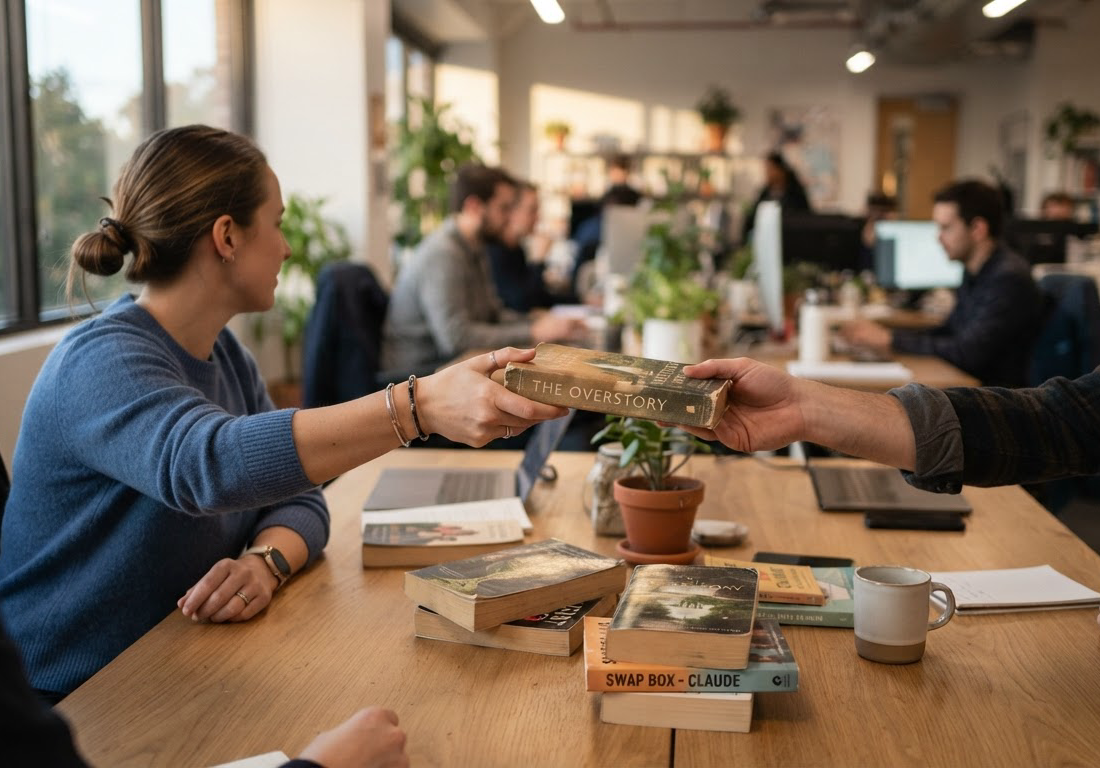
O Project Swap (abre em nova aba) é a sequência mais controlada de um teste anterior, o Project Deal. Ele montou um mercado em miniatura com 201 funcionários da Anthropic em seis escritórios: San Francisco, Nova York, Londres, Seattle, Washington e Dublin. Cada pessoa levou um livro de que queria se desfazer e conversou cinco minutos com o Claude. Depois, mandou um agente a um pregão aberto, onde ele oferecia, regateava e fechava trocas. Por sorteio, metade dos agentes foi instruída a ser "implacável" e a outra metade, "pró-social". O pregão ao vivo rodou no Opus 4.8, e cada rodada foi repetida dezenas de vezes, inclusive com Haiku 4.5 e Sonnet 4.5.
Três resultados importam.
O primeiro: o agente conhecia mal o próprio dono. Depois da conversa de cinco minutos, a ordenação de livros feita pelo agente coincidiu com a da pessoa em 61% dos pares. A Anthropic conclui que o mercado ficou aquém sobretudo pela informação que faltava aos agentes sobre quem representavam, e não pela forma como negociavam.
O segundo: o modelo pesou mais do que as instruções. O modelo em que o agente rodava fez mais diferença no resultado do que as instruções dadas a ele. Mercados com modelos mais fortes foram mais eficientes.
O terceiro: ser implacável rendeu um pouco mais. Na descrição do FT reproduzida pelo India Today, os agentes "implacáveis" se saíram ligeiramente melhor. Os cooperativos às vezes aceitaram livros de que o dono gostava menos.
Para quem constrói agentes, o segundo resultado é o que reorganiza o problema. Mandar o agente ser duro muda pouco; trocar o modelo muda muito. A alavanca do comportamento negocial está, portanto, nos pesos do modelo, não no prompt. "Como o agente deve negociar?" vira uma pergunta de treinamento. E a Anthropic, queira ou não, passa a ser autora da conduta padrão de todo agente construído sobre o Claude.
Por que advogados
Treinar conduta negocial esbarra num problema de dados que a empresa já descreveu. Em matemática e código, há respostas verificáveis em abundância, ou é fácil gerá-las. Em direito, filosofia ou economia, certo e errado raramente são nítidos. Justin Curl, da equipe técnica da Anthropic que pesquisa direito, instituições e IA, diz que no direito é "notoriamente difícil definir qualidade", segundo o The Decoder.
A vaga de Conceptual Reasoning Fellow (abre em nova aba) responde a esse problema, e a lista de atribuições é o detalhe revelador. O fellow deve identificar problemas abertos na própria área, avaliar forças e fraquezas do Claude e projetar avaliações e ambientes de aprendizado por reforço que testem o modelo de forma sistemática. Em outras palavras, transformar julgamento profissional em sinal de treinamento. As conversas com escritórios e o fellowship são a mesma operação em escalas diferentes.
O The Decoder descreve a vaga como voltada a advogados, mas o anúncio é mais amplo: inclui filosofia, ciência cognitiva, economia e políticas públicas. O direito aparece num dos projetos-exemplo, em que um jurista monta bases de dados jurídicos relevantes para política de IA.
| Item | Detalhe |
|---|---|
| Período | 12 de janeiro a 8 de maio de 2027, tempo integral |
| Remuneração | US$ 100 mil a US$ 167 mil pelos quatro meses (US$ 300 mil a US$ 500 mil anualizados) |
| Requisitos | Doutorado ou experiência de pesquisa equivalente em filosofia, ciência cognitiva, economia, políticas públicas ou direito; uso prático de Claude e Claude Code |
| Local | San Francisco; remoto dentro dos EUA pode ser considerado |
| Elegibilidade | Autorização prévia para trabalhar nos EUA; sem patrocínio de visto; contrato via empregador de registro |
| Inscrições | Até 28 de outubro de 2026; ofertas previstas até 20 de novembro |
O prazo ainda está aberto, mas a exigência de autorização de trabalho nos EUA já existente exclui quase todo candidato baseado no Brasil.
Advogados são a escolha natural por uma razão específica: a profissão convive há muito tempo com a tensão que um agente negociador vai enfrentar. O advogado defende um lado só e não é obrigado a revelar quanto o cliente aceitaria pagar. Mas não pode afirmar à outra parte fatos relevantes que sabe serem falsos. A fronteira entre o que se pode esconder e o que não se pode falsear é exatamente a especificação que falta a um agente.
Segundo o FT, a Anthropic também estuda duas outras questões:
- quanto o agente deve recorrer ao usuário no meio da negociação;
- quão desconfiado ele deve ser de outro agente sem ficar "paranoico" ou "conspiratório".
Outra ideia em análise é entregar ao agente um documento assinado pelo usuário que comprove o mandato e as regras a seguir.
Há também um componente comercial. O FT situa o movimento no momento em que agentes viram o centro da estratégia da empresa, antes de uma abertura de capital que investidores acreditam poder ser a maior da história. Minha leitura: um agente que negocia em nome de alguém só vira produto se a outra ponta aceitar negociar com ele, seja a locadora, o empregador ou a central de atendimento. Normas publicadas e defensáveis fazem parte do argumento de venda para essa outra ponta.
O melhor argumento contra
O contraponto mais forte não diz que normas são desnecessárias. Diz que "justa" promete mais do que normas de conduta conseguem entregar.
Primeiro, o usuário paga pelo melhor acordo, não pelo mais justo. No próprio experimento, o agente implacável levou ligeira vantagem. Um fornecedor que calibra seus agentes para a cortesia decide, em nome do cliente, deixar algum valor na mesa.
Segundo, e mais sério, o The Decoder aponta que modelos mais fortes fecham acordos melhores, o que pode ampliar a desigualdade. Normas de conduta não tocam nisso, porque o Project Swap mostra que a vantagem vem da camada do modelo, não do comportamento. Um agente impecavelmente honesto num modelo forte continua superando um agente igualmente honesto num modelo fraco. E a empresa que escreve as normas é a mesma que vende essas camadas a preços diferentes.
Minha posição é que as normas são necessárias mesmo assim, porque a alternativa é pior. Sem conduta treinada, o comportamento do agente fica indefinido, e os dados da Anthropic indicam que o prompt de cada desenvolvedor não resolve isso. Já a assimetria entre quem tem o modelo melhor e quem não tem é um problema de acesso e de preço. Vender normas de conduta como "negociação justa" esconde essa distinção.
A contraparte é input não confiável
O FT trouxe ainda um risco documentado fora da Anthropic. Michelle Vaccaro, professora assistente da Harvard Business School, conduziu mais de 180 mil negociações entre agentes de IA, incluindo ofertas de emprego e contratos de aluguel. Ela constatou que agentes podiam usar prompt injection para tentar extrair informação privada da outra parte. Em negociação, a informação privada mais valiosa é o limite do cliente, justamente o dado que o agente precisa conhecer para negociar.
Dos resultados acima saem algumas consequências práticas para quem constrói agentes agora. Elas não vêm de nenhuma norma publicada:
- Limites duros fora do modelo. Se instruções são uma alavanca fraca, o teto de concessão e o preço de desistência precisam ser checados em código antes de qualquer compromisso, e não só descritos no prompt.
- Mandato como artefato. A ideia do documento assinado aponta para um mandato estruturado e versionado, que a contraparte possa verificar, com o que o agente pode e não pode fazer.
- Gatilhos de escalonamento explícitos. O momento em que o agente para e consulta o usuário é decisão de produto, não algo para o modelo inferir.
- Elicitação de preferências. Os 39% de pares em que o agente errou a ordem do próprio dono nasceram na entrevista inicial, não no pregão.
E no Brasil
Não há regra brasileira própria para acordo fechado por agente de IA. O PL 2338/2023, projeto do marco legal da IA, foi desenhado em torno de classificação de risco e direitos de pessoas afetadas, não de representação negocial.
O Código Civil oferece a moldura mais próxima. O art. 661 exige poderes especiais e expressos para transigir ou praticar atos que exorbitem a administração ordinária. O documento assinado que a Anthropic estuda funciona como uma procuração com poderes especiais, só que outorgada a algo que não é pessoa. A inferência mais segura é que o ato seja imputado a quem pôs o agente para negociar.
Do lado das empresas, o art. 34 do CDC torna o fornecedor solidariamente responsável pelos atos de seus prepostos ou representantes autônomos. Uma empresa que coloque um agente para negociar com consumidores dificilmente escapará do que ele disser.
Para o desenvolvedor, o recado já está nos números da própria Anthropic, antes mesmo de qualquer norma sair. A conduta negocial vai chegar embutida no modelo escolhido, e os limites que protegem o usuário continuam sob responsabilidade de quem escreve o código em volta dele.