
Grandes modelos de linguagem convencionais foram construídos com foco prioritário na geração textual fluida, mas boa parte das arquiteturas de software precisa apenas de roteamentos discretos e validações booleanas de baixa latência. Se um pipeline de processamento em tempo real precisa decidir se uma transação bancária viola políticas de conformidade, se uma mensagem de suporte deve ser escalada para a fila de retenção ou se determinado payload deve disparar um webhook, a geração de sentenças explicativas em linguagem natural é um custo computacional desnecessário. Esse desacoplamento entre o esforço de geração textual e a demanda estrita por classificação decisória é o problema que a TypeSafe AI (abre em nova aba) buscou atacar com o lançamento do Jev.
Apresentado formalmente em 15 de setembro de 2026 pelo fundador Diogo Almeida, ex-pesquisador da OpenAI, o Jev introduziu a categoria comercial denominada pela empresa de "modelos System One". Em psicologia cognitiva, operações de Sistema 1 representam reações rápidas, heurísticas e de julgamento imediato, em contraste com a deliberação analítica e lenta do Sistema 2. No ecossistema de inteligência artificial aplicada, essa analogia foi traduzida na criação de uma rede que não gera parágrafos discursivos: seu propósito reside exclusivamente em emitir escolhas estruturadas que o código consumidor possa deserializar diretamente.
Para os profissionais que gerenciam microsserviços, orquestrações assíncronas e esteiras de dados, essa premissa exige uma mudança metodológica significativa. Adotar esse modelo demanda descartar as estratégias tradicionais de prompt engineering focadas em formatação de prosa e entender como estruturar estados contextuais para um motor de inferência veloz, determinístico na forma, mas com limites operacionais bem delineados.
Para quem é este modelo
O modelo Jev atende principalmente a três grupos técnicos distintos que enfrentam gargalos de latência e custo ao tentar integrar inteligência probabilística em código de produção:
- Engenheiros de software de microsserviços: equipes que constroem gateways de API, proxies reversos e sistemas orientados a eventos nos quais respostas precisam trafegar abaixo do teto de 500 milissegundos.
- Engenheiros e analistas de dados: profissionais que desenham pipelines de ingestão contínua em ferramentas como Apache Kafka ou Apache Spark e necessitam filtrar, enriquecer ou descartar registros conforme regras semânticas complexas.
- Arquitetos de automação e agentes: desenvolvedores de fluxos compostos em que modelos maiores de raciocínio são caros demais para executar checagens intermediárias de guarda ou bifurcações simples de fluxo.
Em contrapartida, o Jev não atende equipes que buscam construção de agentes de conversação aberta com usuários finais, geração de resumos textuais, tradução de idiomas ou escrita criativa. O motor não foi treinado para redigir textos, mas sim para avaliar e categorizar dados de entrada.
A mecânica dos modelos System One e a pilha da TypeSafe AI
Diferente de modelos autoregressivos genéricos que alocam grande capacidade de processamento para calcular a distribuição de probabilidade de cada token textual subsequente, o Jev utiliza uma pilha focada em eficiência estrutural. O projeto integra uma arquitetura proprietária, um amostrador paralelo (parallel sampler) voltado à otimização de throughput e um paradigma de treinamento denominado RLCD (Reinforcement Learning for Calibrated Decisions, ou aprendizado por reforço para decisões calibradas).
A abordagem de calibração visa alinhar a distribuição de confiança do modelo às probabilidades reais de precisão da escolha. Em termos práticos de software, isso significa que a pontuação atribuída a cada opção selecionável tende a refletir com menor distorção se a inferência é de fato sustentada pelo estado fornecido.
A implementação atual disponível em produção, identificada como jev-1.13.0 (para a qual apontam os aliases de versionamento jev-latest e jev-preview), impõe restrições severas sobre como os dados circulam na rede. Conforme a documentação técnica da TypeSafe AI (abre em nova aba), o modelo aceita apenas texto simples, objetos JSON ou vetores de valores de texto. Não há suporte nativo para modalidades visuais, dados de áudio ou fluxos de vídeo.
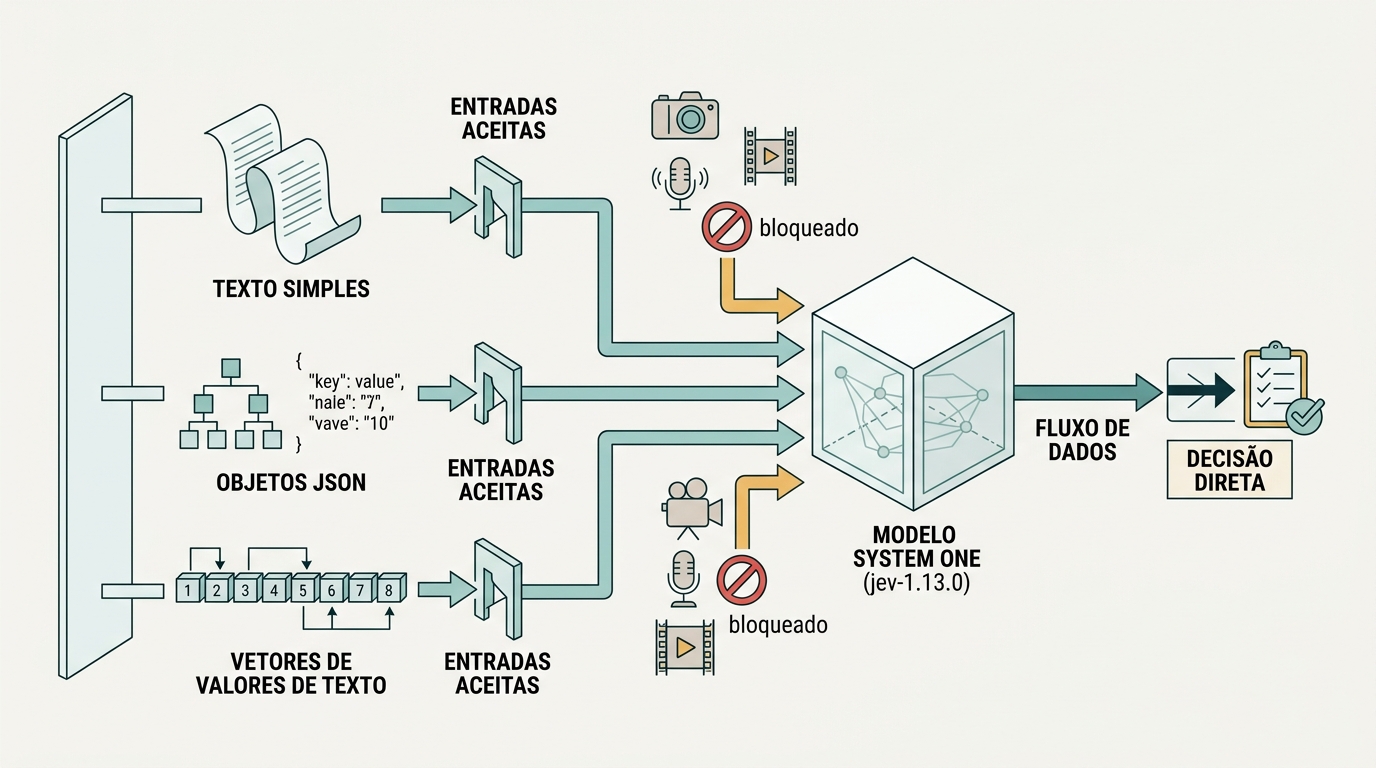
As cotas de contexto e tráfego são delineadas em termos técnicos estritos:
- Comprimento de contexto total: 64.000 tokens por requisição.
- Divisão do contexto: o payload reserva até 32.000 tokens para o estado cumulativo da aplicação, alocando a margem restante para os critérios decisórios e a pergunta mais longa.
- Limites de requisições: teto de 1.200 requisições por minuto (RPM).
- Vazão de tokens: taxa de 250.000 tokens por segundo (TPS), com limites ajustados dinamicamente pela infraestrutura da empresa.
- Ajustes de modelo: os mesmos pesos imutáveis atendem a todas as contas de clientes; não existe suporte para fine-tuning individual ou adaptações de baixa ordem (LoRA) com dados de clientes.
Essa padronização da inferência tem relação direta com os impactos de latência e consumo orçamentário medidos nos sistemas consumidores.
Métricas operacionais, velocidade e estrutura de preços
Ao eliminar o gargalo autoregressivo de escrita de texto token a token, a TypeSafe AI divulgou que o tempo de resposta ponta a ponta (end-to-end) do Jev oscila tipicamente entre 70 milissegundos e 500 milissegundos. Nos dados fornecidos pela fornecedora a partir de avaliações em quatro fluxos de trabalho de referência (comparados à média aritmética entre GPT-6 Astra e Fable 5.1), o ganho de velocidade chegou a 193,6 vezes, com uma redução de custo computacional avaliada em até 444,6 vezes.
O modelo financeiro da API difere do padrão clássico do setor de inteligência artificial. A cobrança incide apenas na ingestão de dados, tornando as saídas estruturadas financeiramente neutras:
| Métrica | Parâmetro oficial |
|---|---|
| Custo de entrada (por milhão de tokens - Mtok) | US$ 0,042 |
| Custo de entrada (por bilhão de tokens - Btok) | US$ 42,00 |
| Custo de saída (output tokens) | Gratuito ($0,00) |
| Latência ponta a ponta | 70 ms a 500 ms |
| Limite de taxa por minuto | 1.200 requisições |
| Throughput de tokens | 250.000 tokens/s |
| Janela de contexto máxima | 64k tokens (32k para estado) |
Esse desenho de custos torna o processamento em lote e a triagem contínua altamente previsíveis: como o desenvolvedor sabe exatamente quantos tokens compõem seu estado e seus critérios de decisão, o custo da inferência independe do comprimento ou do tipo da escolha retornada pelo sistema.
Essa previsibilidade permitiu uma rápida disseminação da tecnologia entre provedores terceiros após a estreia de setembro de 2026. A Vercel incluiu suporte ao Jev via seu AI Gateway na data do lançamento original em regime promocional, encerrando a gratuidade de entrada em 25 de setembro de 2026 para acompanhar o preço padrão de US$ 0,042 por milhão de tokens. A plataforma OpenRouter listou o modelo sob a etiqueta typesafe/jev-1.13 em 18 de setembro de 2026. Em 21 de setembro, a TypeSafe liberou a versão 0.7.1 de seu SDK Python e abriu o registro direto sem fila de espera, embora tenha suspendido temporariamente novos cadastros em 22 de setembro para estabilização de capacidade, mantendo os acessos existentes funcionais.
Com a viabilidade de custo e tempo de resposta compreendida, o passo lógico seguinte é a implementação prática da chamada de API na camada de aplicação.
Pré-requisitos de implementação
Antes de integrar o modelo ao fluxo de trabalho, certifique-se de preencher os seguintes requisitos técnicos:
- Chave de acesso válida fornecida pelo console da TypeSafe AI ou via agregador compatível devidamente autenticado.
- Ambiente de execução com Python 3.10 ou superior configurado.
- Biblioteca do cliente oficial atualizada na versão compatível.
Instale o SDK oficial da empresa por meio do gerenciador de pacotes pip:
pip install typesafe-ai==0.7.1Evite a instalação sem fixação de versão, garantindo paridade com as convenções do release de setembro de 2026.
Passo a passo de integração prática
A aplicação típica do Jev envolve fornecer um bloco de estado (fatos concretos sobre uma transação, usuário ou ticket de suporte), estabelecer regras operacionais e solicitar a seleção de uma chave decisória correspondente.
Passo 1: Configuração das credenciais e do cliente
Exporte sua credencial de ambiente de maneira isolada antes de iniciar o processo de execução:
export TYPESAFE_API_KEY="ts_live_exemplo_chave_segura"Em seguida, inicialize o cliente dentro do seu módulo Python:
import os
from typesafe import TypeSafeClient

client = TypeSafeClient(api_key=os.environ.get("TYPESAFE_API_KEY"))
Passo 2: Estruturação do estado e das regras de negócio
O Jev opera com maior eficácia quando o estado está estruturado em dados objetivos, desprovido de considerações opinativas. Separe os dados puros dos critérios classificatórios:
estado_contextual = {
    "usuario_tempo_conta_dias": 14,
    "valor_transacao_brl": 4850.00,
    "dispositivo_novo": True,
    "historico_estornos": 0,
    "geolocalizacao_ip_divergente": True
}

criterios_classificacao = [
    "APROVAR: conta antiga com valor baixo em dispositivo reconhecido",
    "REVISAR_MANUALMENTE: transacao acima de 3000 em dispositivo novo ou IP divergente",
    "BLOQUEAR: multiplos estornos anteriores ou valor incompativel com limites cadastrais"
]
Passo 3: Envio da requisição de inferência
Envie a chamada especificando a versão imutável jev-1.13.0 ou o alias jev-latest. Indique os candidatos de decisão explicitamente:
resposta = client.decisions.create(
    model="jev-1.13.0",
    state=estado_contextual,
    criteria=criterios_classificacao,
    choices=["APROVAR", "REVISAR_MANUALMENTE", "BLOQUEAR"],
    question="Qual e o encaminhamento regulatorio adequado para esta transacao?"
)
Por não exigir decodificação textual iterativa via streaming, o objeto retornado contém a resolução resolvida pelo parallel sampler.
Passo 4: Leitura determinística do resultado
Consuma os dados retornados tratando o resultado diretamente na lógica condicional de sua aplicação de backend:
decisao_tomada = resposta.choice
confianca_estimada = resposta.calibration_score

if decisao_tomada == "REVISAR_MANUALMENTE":
    print(f"Roteando para fila de analistas. Indice calibrado: {confianca_estimada}")
elif decisao_tomada == "APROVAR":
    print("Transacao autorizada imediatamente pelo gateway.")
else:
    print("Transacao interceptada por politicas de risco.")
Essa abordagem dispensa o uso de regex ou validadores sintáticos como Pydantic para garantir que o LLM não inclua introduções como "Certamente! A decisão é...". O modelo responde estritamente no formato exigido pela chamada.
Verificação da execução
Para assegurar que o serviço está operando sob os limites nominais de latência e precisão, execute testes de carga controlados observando os cabeçalhos de resposta HTTP fornecidos pela infraestrutura da TypeSafe:
curl -X POST https://api.typesafe.ai/v1/decisions \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": {"ping": "healthcheck"},
    "criteria": ["OK: estado normal", "FALHA: sistema com instabilidade"],
    "choices": ["OK", "FALHA"],
    "question": "Status da comunicacao?"
  }' -w "\nTempo total: %{time_total}s\n"
A verificação deve atestar tempo total de ida e volta compatível com a janela anunciada de até 500 milissegundos para conexões estáveis. Tempos superiores a 1 segundo costumam indicar gargalos de conectividade de rede externa, e não na inferência primária do modelo.
Entretanto, utilizar o Jev de maneira eficaz em sistemas de missão crítica requer a compreensão profunda de suas restrições operacionais e pontos de fragilidade.
As arestas da versão 1.13: modos de falha documentados
Diferente de muitas fabricantes que tratam deficiências de modelos como casos isolados de borda, a TypeSafe AI mantém uma postura de engenharia defensiva ao publicar abertamente a documentação de "irregularidades" (model jaggedness) aplicável ao release jev-1.13. Essas limitações determinam precisamente até onde o modelo deve atuar e onde o código determinístico tradicional deve prevalecer.
A documentação oficial elenca 9 modos específicos de falha:
- **Leitura literal (literal reading)**: o modelo avalia a pergunta exata que você escreveu na requisição, e não a intenção tácita do operador. Falhas de redação nas condicionais produzem desvios de rota sem qualquer tentativa de correção contextual por bom senso.
- **Matemática e contagem (math and numbers)**: o Jev não executa operações aritméticas nem contagens com consistência confiável. Se um critério depender de comparações numéricas como
saldo < debito + taxa, esse cálculo precisa ser resolvido antecipadamente em código determinístico (Python, Rust, Go) antes de passar o valor consolidado ao estado. - **Comparação de datas e fusos horários (date and time comparison)**: avaliações cronológicas relativas falham com frequência. Intervalos como "usuário cadastrado há menos de 48 horas" não devem ser deixados para dedução do modelo; a aplicação deve calcular a diferença de timestamps e injetar um booleano
menor_que_48h: true. - **Indireção (indirection)**: o grau de precisão cai acentuadamente diante de negações duplas, estruturas sintáticas ambíguas ou saltos lógicos encadeados com múltiplos passos de dependência.
- **Estado inflado de dados irrelevantes (large state full of irrelevant detail)**: embora a janela aceite até 32.000 tokens de estado, a inclusão indiscriminada de logs brutos e campos contextuais sem relação com a decisão degrada a assertividade do sistema.
- **Conteúdo adversário (adversarial content)**: entradas contendo tentativas explícitas de injeção de prompt podem desestabilizar as restrições da requisição, exigindo filtros sanitizadores na entrada de dados.
- **Critérios contraditórios (contradictory instructions and criteria)**: se duas opções forem formuladas de maneira sobreposta ou conflitante, o modelo não emite alerta de ambiguidade; ele força uma escolha, comprometendo o índice de calibração.
- **Invariantes estruturais de bom senso (common-sense structural invariants)**: o motor não assegura premissas implícitas do mundo físico ou regras jurídicas a menos que elas estejam claramente descritas como critérios na requisição.
- **Geração textual (generation)**: o modelo não foi treinado para síntese ou redação contínua. Tentativas de forçá-lo a compor parágrafos resultam em quebras imediatas de operação.
O mapeamento desses pontos fracos auxilia a mitigar os erros de implantação mais recorrentes observados por equipes de dados e DevOps.
Erros comuns e medidas preventivas
Ao construir esteiras de automação orientadas ao Jev, desenvolvedores costumam tropeçar em padrões herdados de pipelines desenhados para modelos LLM generativos:
- Tratar o Jev como um substituto de agentes conversacionais: tentar plugar o endpoint da TypeSafe em chatbots esperando respostas de atendimento. A aplicação falhará ou emitirá erros de requisição, uma vez que o contrato da API exige listas finitas de opções e devolve escolhas atomizadas.
- Poluição descontrolada do payload de estado: empacotar objetos completos de bancos de dados relacionais dentro do JSON de entrada sem pré-filtragem. A prática estoura a tolerância à dispersão contextual, ativando o modo de falha por excesso de ruído irrelevante. Envie apenas as propriedades que impactam diretamente a pergunta formulada.
- Depender de aliases em ambientes de missão crítica: utilizar
jev-latestoujev-previewem pipelines corporativos estáveis. Embora esses aliases apontem parajev-1.13.0, atualizações subsequentes da API podem alterar heurísticas de decisão. Trave explicitamente a tag de versãojev-1.13.0nos manifestos de configuração e arquivos de ambiente do seu sistema. - Ignorar a ausência de personalização por conta: supor que dados enviados em requisições anteriores criarão um contexto retido por fine-tuning ou adaptação contínua. Os pesos do Jev são uniformes para todos os consumidores e a inferência não retém estado entre requisições distintas (stateless por definição).
Gerenciar esses fatores de forma assertiva define a fronteira entre um pipeline de decisão resiliente e um microsserviço instável.
Avaliação comparativa e julgamento técnico
O Jev e o conceito de modelos System One não representam a substituição dos LLMs deliberativos tradicionais, mas sim uma reorganização do ferramental técnico para automação. Por anos, a engenharia de software foi levada a utilizar modelos massivos de centenas de bilhões de parâmetros operando a 1 ou 2 segundos por inferência para resolver problemas triviais de classificação e roteamento condicional de dados.
A TypeSafe AI construiu uma solução cirúrgica: abdicou voluntariamente de qualquer capacidade de conversação, áudio, visão e cálculos matemáticos para entregar um motor de inferência que avalia regras textuais estruturadas a custos desprezíveis (US$ 0,042 por milhão de tokens de entrada com saída gratuita) e latências que viabilizam seu uso no caminho crítico de microsserviços convencionais.
Para arquiteturas que exigem raciocínio complexo encadeado, redação de documentos técnicos ou análise de cenários abertos e reflexivos, modelos fundacionais de propósito geral continuam insubstituíveis. Nesses cenários deliberativos de Sistema 2, o Jev é inadequado por projeto. Contudo, em esteiras de engenharia de dados, triagem assíncrona de eventos, classificação semântica de chamados e barreiras de contenção para sistemas complexos, o modelo da TypeSafe se firma como um componente arquitetural de altíssimo retorno de eficiência operacional.
Para dar os próximos passos, audite os fluxos da sua arquitetura onde modelos generativos lentos estão alocados para responder classificações discretas, isole os cálculos numéricos na camada de código de backend e estruture um piloto controlado do jev-1.13.0 para absorver a camada de decisão em tempo real.