
Notícia
Google Research apresenta sistema para vídeos longos coerentes
Em 24 de setembro de 2026, Google Research divulgou um conjunto de sistemas multiagentes para planejar, gerar e revisar vídeos longos com continuidade visual. A empresa afirma ganhos de consistência, mas a demonstração de dez minutos cobre apenas parte da abordagem.
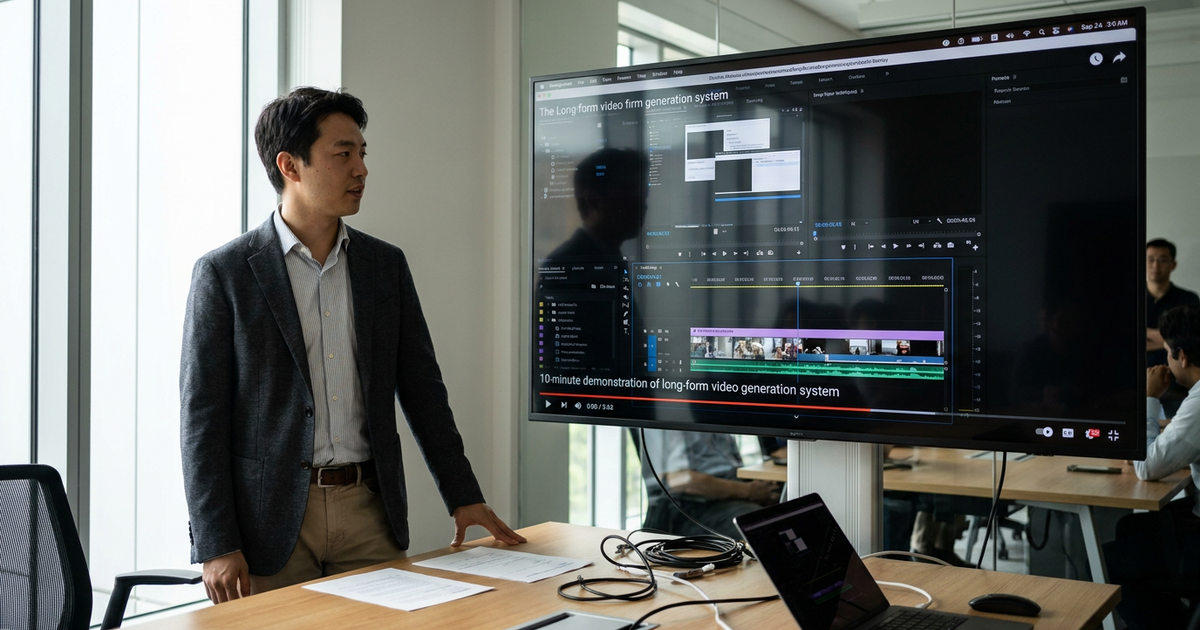
Em 24 de setembro de 2026, o Google Research apresentou um conjunto de sistemas para automatizar a criação de vídeos longos e coerentes. A promessa é reduzir um problema que incomoda quem usa inteligência artificial para contar histórias: personagens, roupas e cenários que mudam sem querer quando a história passa de um plano para outro. A divulgação teve desdobramentos em 25 de setembro, quando outros relatos do setor passaram a circular.
O que é
Trata-se de um framework multiagente. Em termos simples, um framework é um conjunto de peças que organiza o trabalho. Multiagente significa que várias partes do programa atuam como uma equipe, cada uma com uma função: planejar, criar imagens, montar cenas, gerar áudio e revisar o resultado. A ideia não é substituir os modelos que já criam vídeo, como Gemini e Veo. O sistema funciona como uma camada de coordenação sobre eles.
Por que importa
Modelos de difusão, que geram vídeos realistas em segundos, ainda têm dificuldade de manter uma história longa. A empresa descreve dois problemas principais. O primeiro é a deriva semântica: pequenas mudanças de roupa, objeto ou paisagem entre planos. O segundo é a falha em cascata: um erro em uma peça inicial contamina etapas seguintes. Isso se parece com uma linha de montagem em que uma peça torta no começo estraga o produto no fim. A empresa também cita deriva de recurso, quando entidades e ambientes mudam sem intenção, e colapso de conteúdo, quando a narrativa deixa de avançar. Em termos práticos, corrigir só o clipe final pode não resolver a decisão que gerou o erro.
Como funciona
O projeto reúne quatro sistemas. O primeiro é o AI video co-director, uma espécie de diretor assistente. Ele recebe uma especificação criativa humana e escolhe estratégia, estrutura de história e estilo visual. Para isso, usa um algoritmo de bandido multibraço (multi-armed bandit, em inglês), que testa opções e aprende quais caminhos criativos parecem melhores. A escolha alimenta agentes que montam roteiro visual, quadros-chave, planos em movimento e áudio. Depois, um modelo avalia a montagem e devolve a avaliação para outro ciclo de produção.
O segundo sistema é o CANVAS. Ele funciona como uma memória visual. Guarda referências e registros de personagens, locais e objetos. Quando a história volta a um cenário anterior, o sistema recupera essas referências em vez de criar uma descrição nova. No exemplo do roubo em museu citado pelos pesquisadores, a geração direta teria mudado um artefato e alterado a disposição da sala. Outro sistema teria perdido o boné de um ladrão entre cortes. O CANVAS é apresentado como forma de manter detalhes recorrentes. A comparação, porém, é ilustrativa e foi fornecida pelos próprios pesquisadores. Ela não prova que toda história longa vai se manter coesa.
O terceiro é o A²RD, que gera vídeo em segmentos. Ele guarda contexto das partes anteriores. Em um novo trecho, pode estender a ação para um novo momento da história ou ancorar a cena em pessoas e lugares já vistos. A troca entre esses modos ajudaria a narrativa a avançar sem que o mundo visual mude aos poucos.
O quarto é o VQQA. Ele faz perguntas visuais direcionadas sobre o vídeo gerado. As respostas de um modelo de visão e linguagem orientam mudanças no prompt, a instrução em texto. Depois, o sistema gera outro candidato. O VQQA não pinta sobre quadros defeituosos. Ele compara candidatos com o pedido original para que uma correção local não afaste o resultado da cena pretendida.
Demonstração e limites
Uma demonstração divulgada inclui um filme de dez minutos feito com o A²RD. A duração é notável para um sistema que gera segmentos conectados, mas a peça demonstra apenas esse sistema. Ela não mostra, por si só, como o co-director, o CANVAS e o VQQA se comportam juntos em outras histórias. O Google Research afirma ganhos substanciais em consistência de múltiplos planos e persistência de personagens nas avaliações. A empresa apresenta os quatro sistemas como pesquisa, não como produto para criadores.
Segurança e próximos passos
Como o framework é uma cam
Fontes
- Automating coherent long-form video generation - Google Research — research.google · 24/09/2026
- Google's AI Video Co-Director Enhances Long-Form Production ... — welcome.ai · 24/09/2026
- Automating Coherent Long-form Video Generation | AI Timeline — spidits.com · 24/09/2026
- Google Research Introduces AI Systems for Longer, More Consistent Videos | Superpower Daily — superpowerdaily.com · 24/09/2026
- The MagicLight Ai Invitation code is f1m2zyhp4 | Community — community.intercom.com · 20/09/2026
Comentários
Faça login para comentar nesta notícia.
Nenhum comentário ainda. Seja o primeiro!